开场|第 1 页|从 fork() 到 Fleet
这一期,我们看 OpenAI RL 与 Agent 基础设施团队的 Abhishek Bhardwaj。他想回答的是:如果最初只是在单机上 fork() 一个进程来执行工具,怎样一步步增加安全隔离、状态恢复和跨机器调度,最终建成一套 Agent Sandbox Cloud。
这个系列,我们少听二手观点,直接听一线 AI Builders 亲口讲。看看他们是怎么想、怎么做的。
第 2 页|Sandbox Cloud 的三根支柱
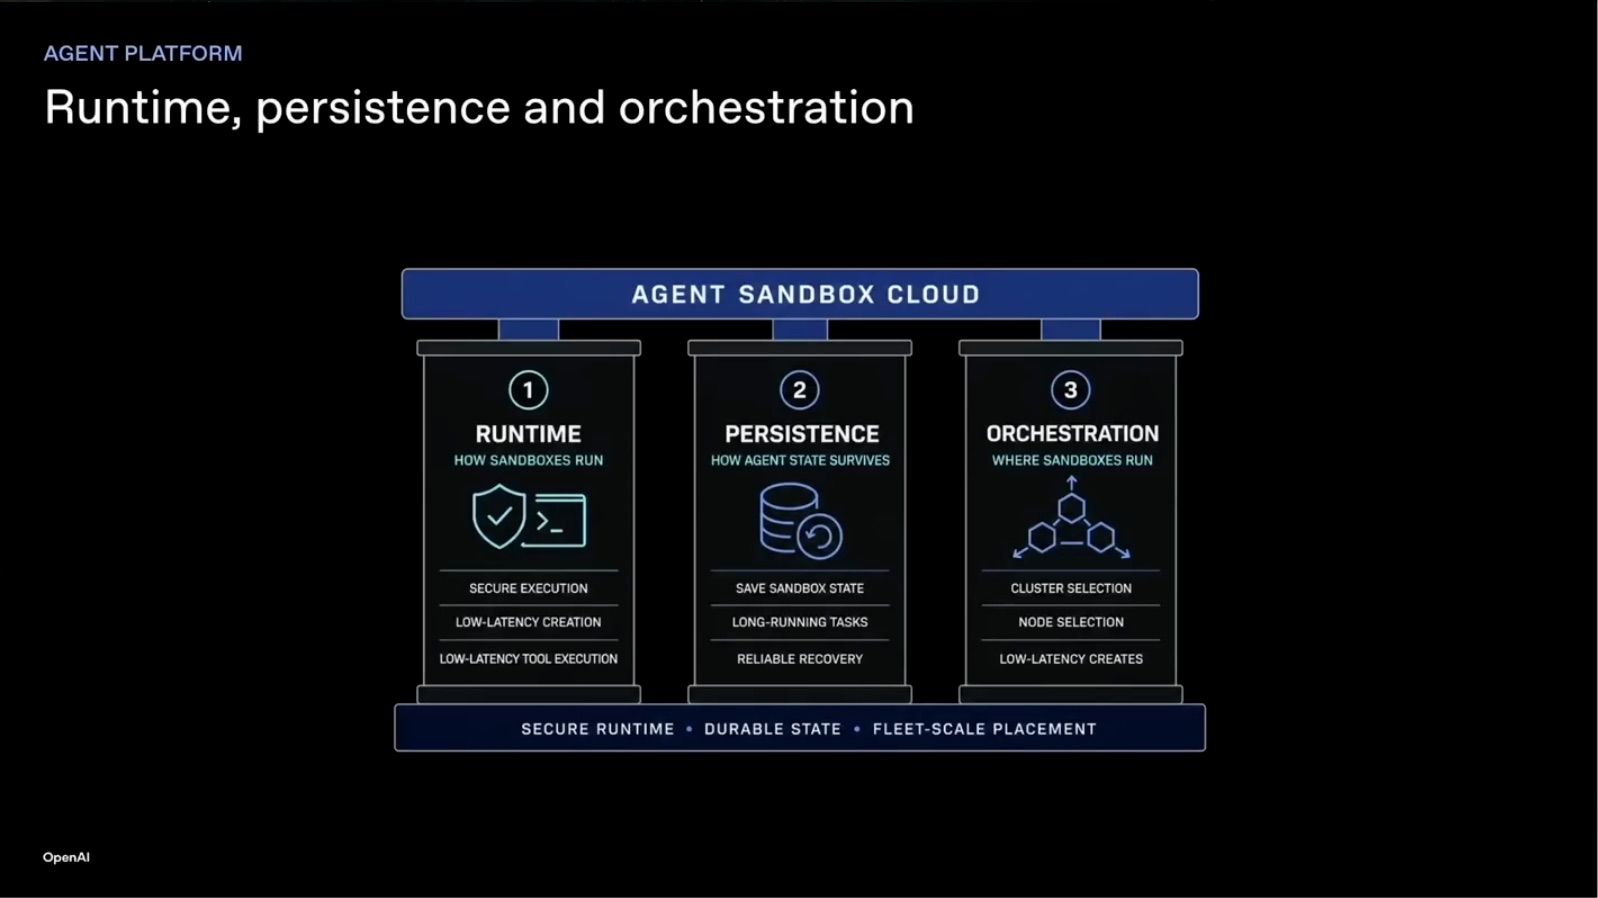
先看这张总图。最上面是这场分享要建的整体:Agent Sandbox Cloud。往下看,它由三根支柱撑起来。
左边的 Runtime,解决代码怎样在单个节点上安全运行;中间的 Persistence,解决状态怎样保存、恢复和分支;右边的 Orchestration,解决大量沙箱怎样分配到不同机器和区域。
图最下面的三个短语,对应这三部分最后要交付的能力:可控的运行时、可持续的状态,以及面向整个机器集群的调度。
我们后面就沿着这张图从左往右走。但进入 Runtime 之前,先看 Abhishek 为什么把问题从“做一个沙箱”推到了“建一朵沙箱云”。
第 3 页|这场分享从哪里接上来
这是 Abhishek 去年《How to Build an AI Sandbox from Scratch》的续篇。上次讨论怎样做出一个沙箱;这次继续讨论怎样把它扩展成服务大量 Agent 的云。
标题里的 fork() 是单机启动进程的起点,Fleet 是跨机器、跨区域运行大量沙箱的终点。本期讲云端架构;Codex 本地 sandbox 留到下半期。
他的起点不是某一种隔离技术,而是 Agent 为什么需要真正执行代码。
第 4 页|工具调用为什么会进入训练
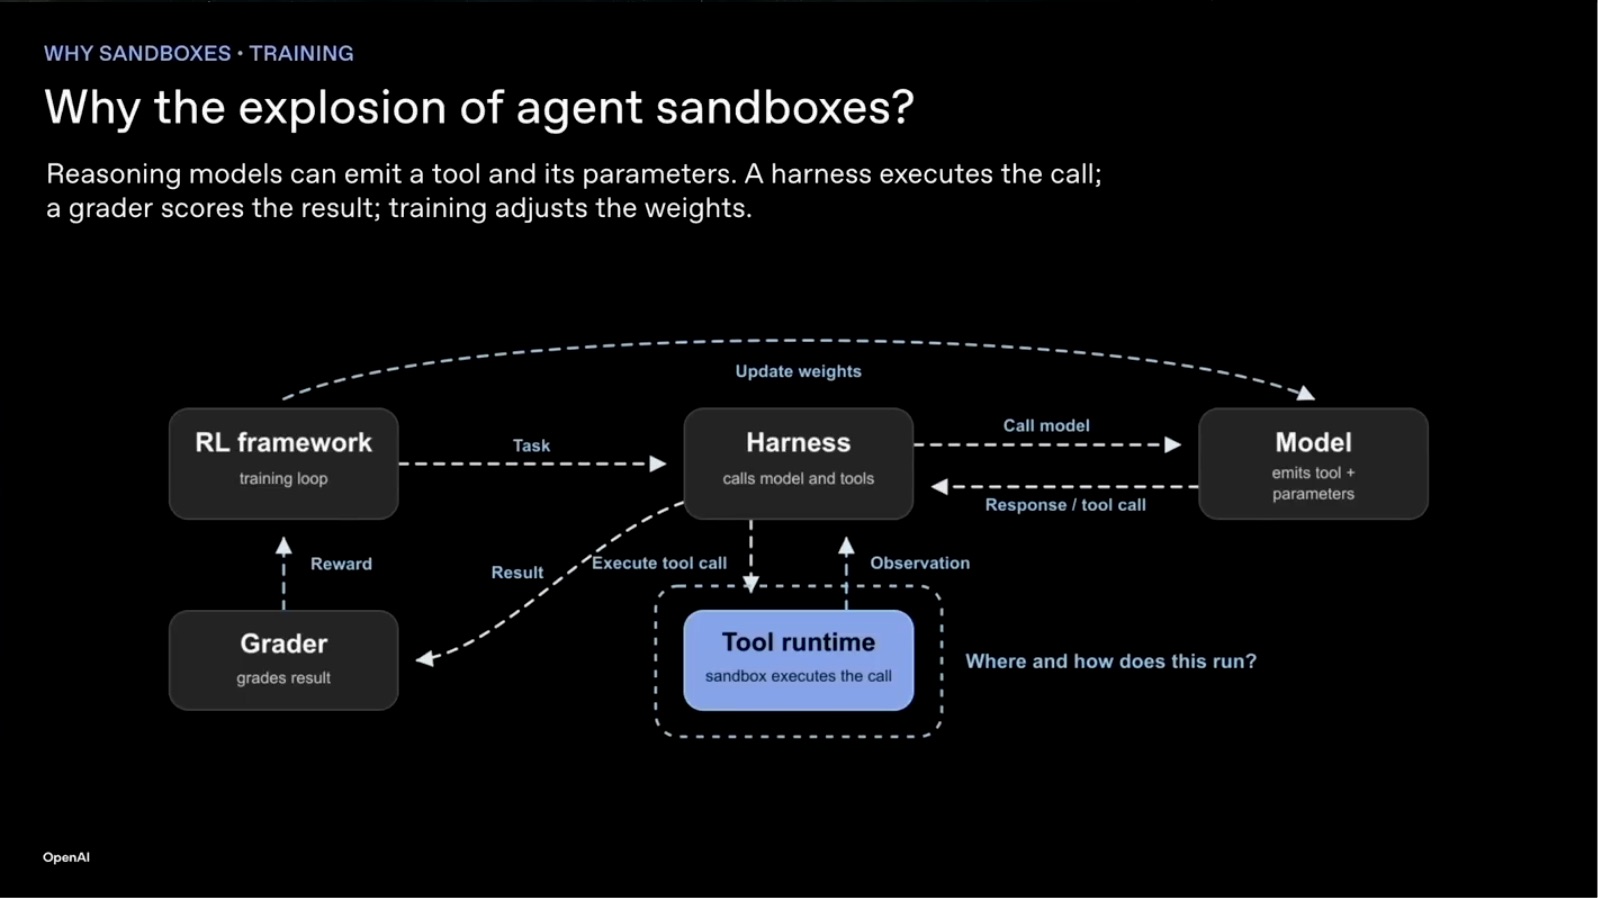
Abhishek 先补了一个前提。只靠预训练,模型是在预测一个可能的答案;但代码和数学任务通常有可以验证的结果。让模型执行代码,它就能真的计算、测试,再根据结果继续修正。
先看图的右边,Model 生成一次响应。响应回到中间的 Harness 后,如果里面要求执行代码,Harness 就把它交给下方的 Tool Runtime。
再沿回路往左看,Grader 检查结果是否真的解决了任务;最上方的训练循环再根据这个信号更新模型权重。
所以这里同时在教模型两件事:什么时候该调用工具,以及它通过工具完成的工作是否有效。Harness 和 Grader 都在模型外部。这张图讲的是 Agent 后训练,不是基础模型预训练。
训练时 Tool Runtime 已经进了闭环。模型到了产品里,这个执行环境同样不能消失。
第 5 页|到了产品侧,少了什么
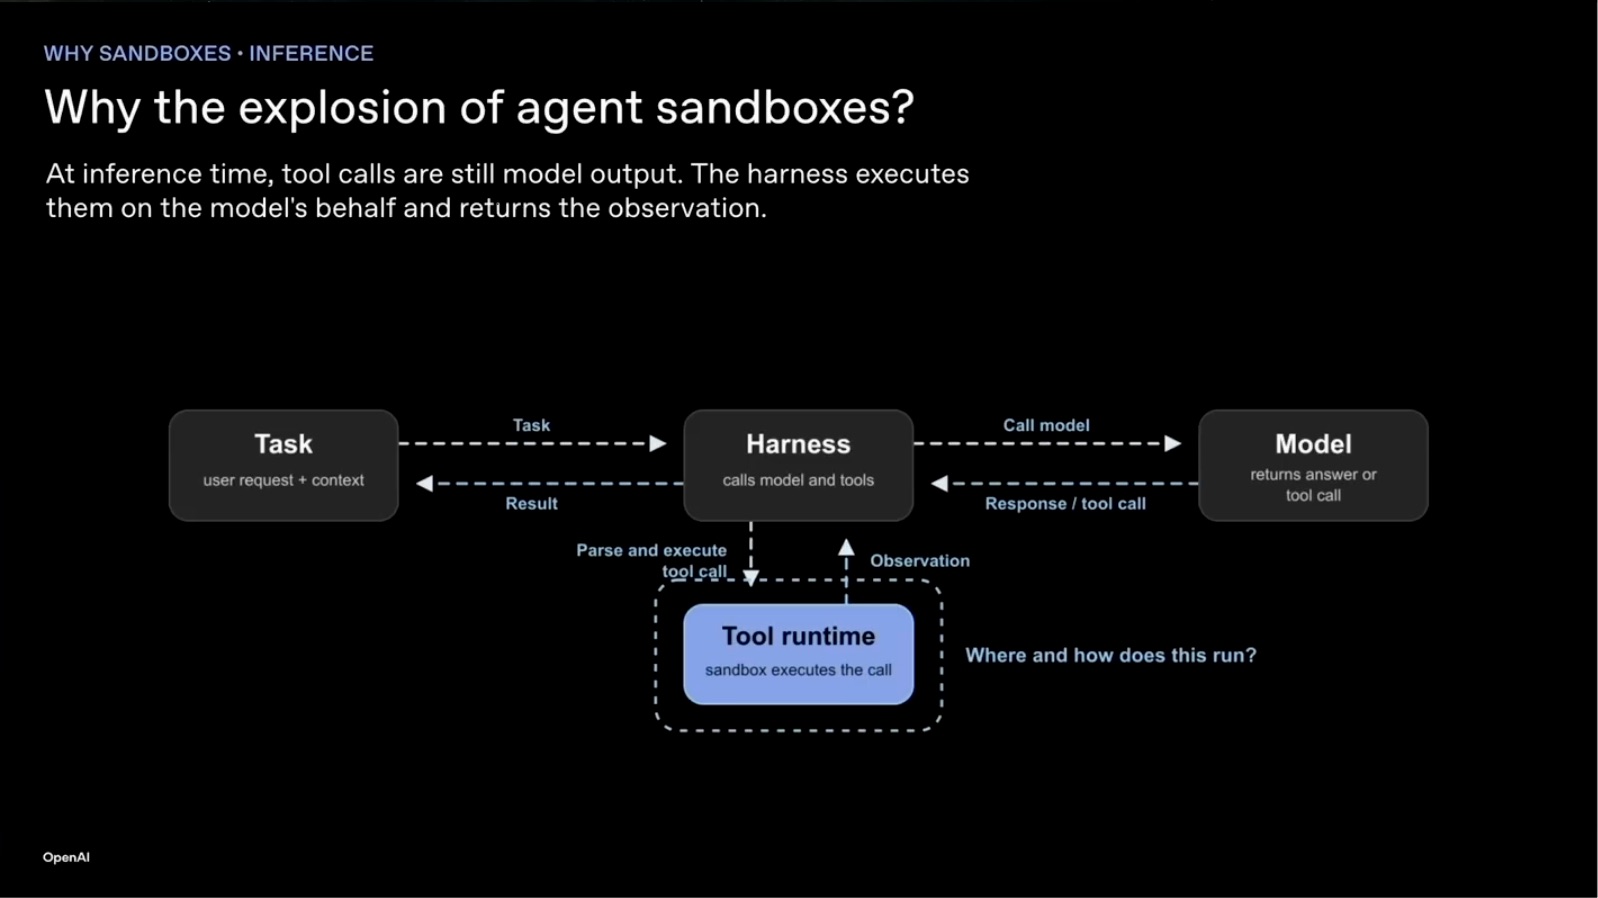
这张图和上一页很像,但左边的训练循环和 Grader 消失了。剩下的路径从左边的用户任务进入中间的 Harness,再到右边的 Model。
如果模型要调用工具,Harness 就沿着向下的箭头把请求交给 Tool Runtime。执行结果作为 observation 回到 Harness,模型再决定继续调用工具,还是返回答案。
代码可能运行在你的电脑,也可能运行在 ChatGPT 或 Codex Web 的云端节点。这些代码不能任意提权、攻击内核,或读取其他用户的数据。Sandbox 就是 Harness 与真实计算资源之间的受控执行环境。
第 6 页|为什么 Agent 会走向云端常驻
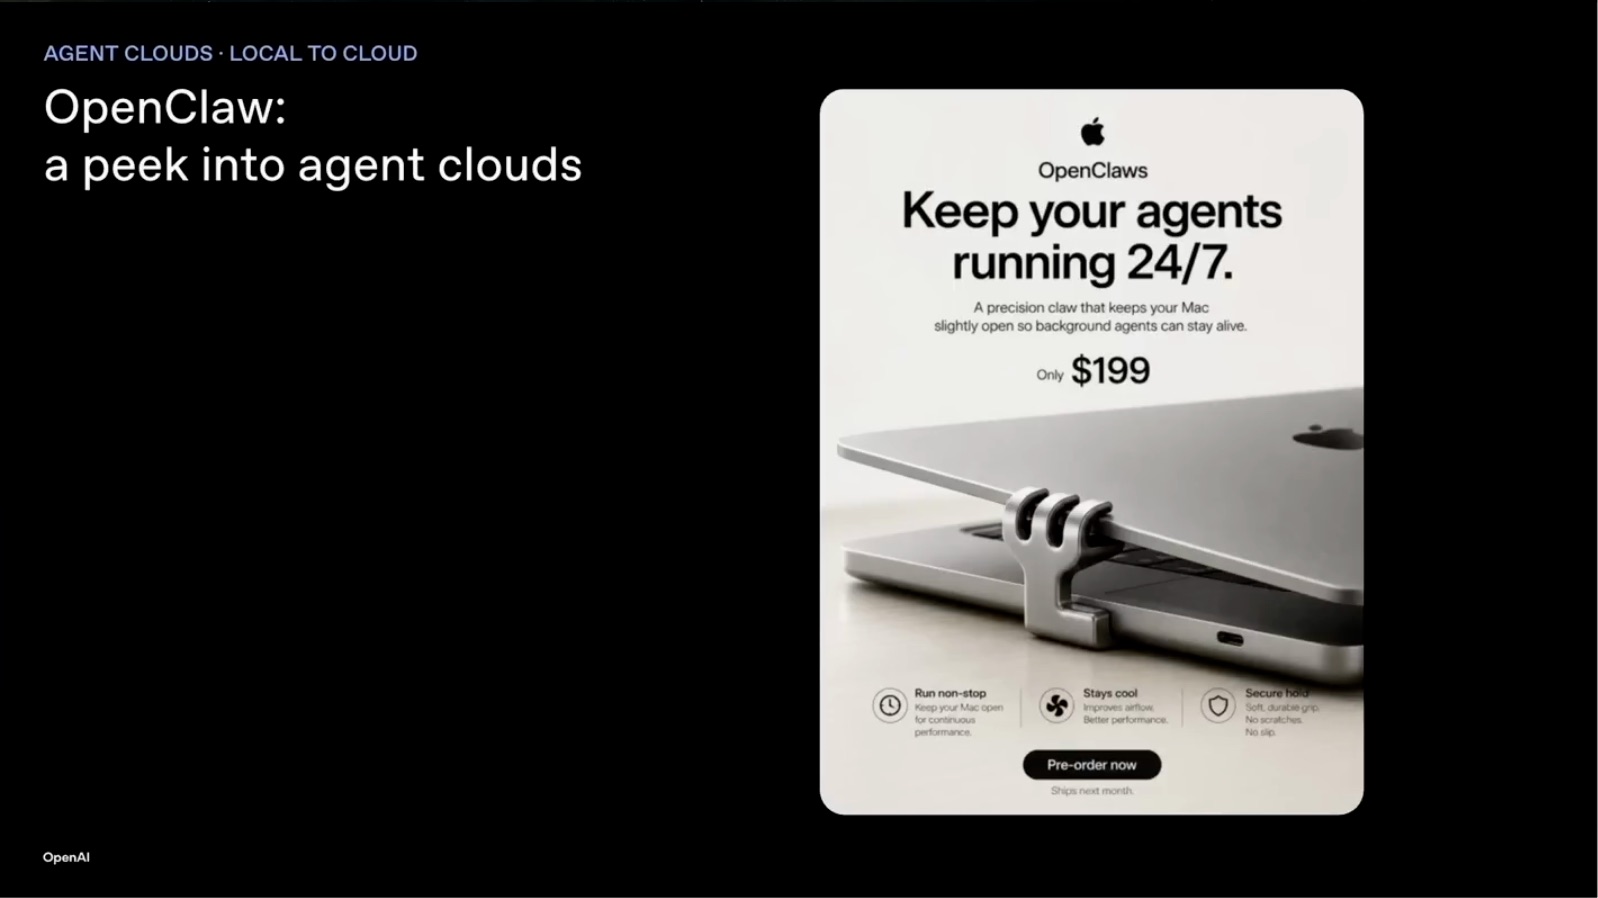
OpenClaw 等产品已经让人们开始把 Agent 长期运行在笔记本、VPS、Hetzner或云端 Mac mini 上。
在 Abhishek 看来,这预示了 Agent 的下一步:它需要的不只是偶尔执行一条命令,而是一台可以持续工作、保存状态的云端计算机。Sandbox Cloud 未来要承接的,正是这类需求。
这就是从一次工具调用走向云端常驻的一步。不过,同一套平台放在训练和产品里,首先要优化的指标并不相同。
第 7 页|研究和产品的目标不同
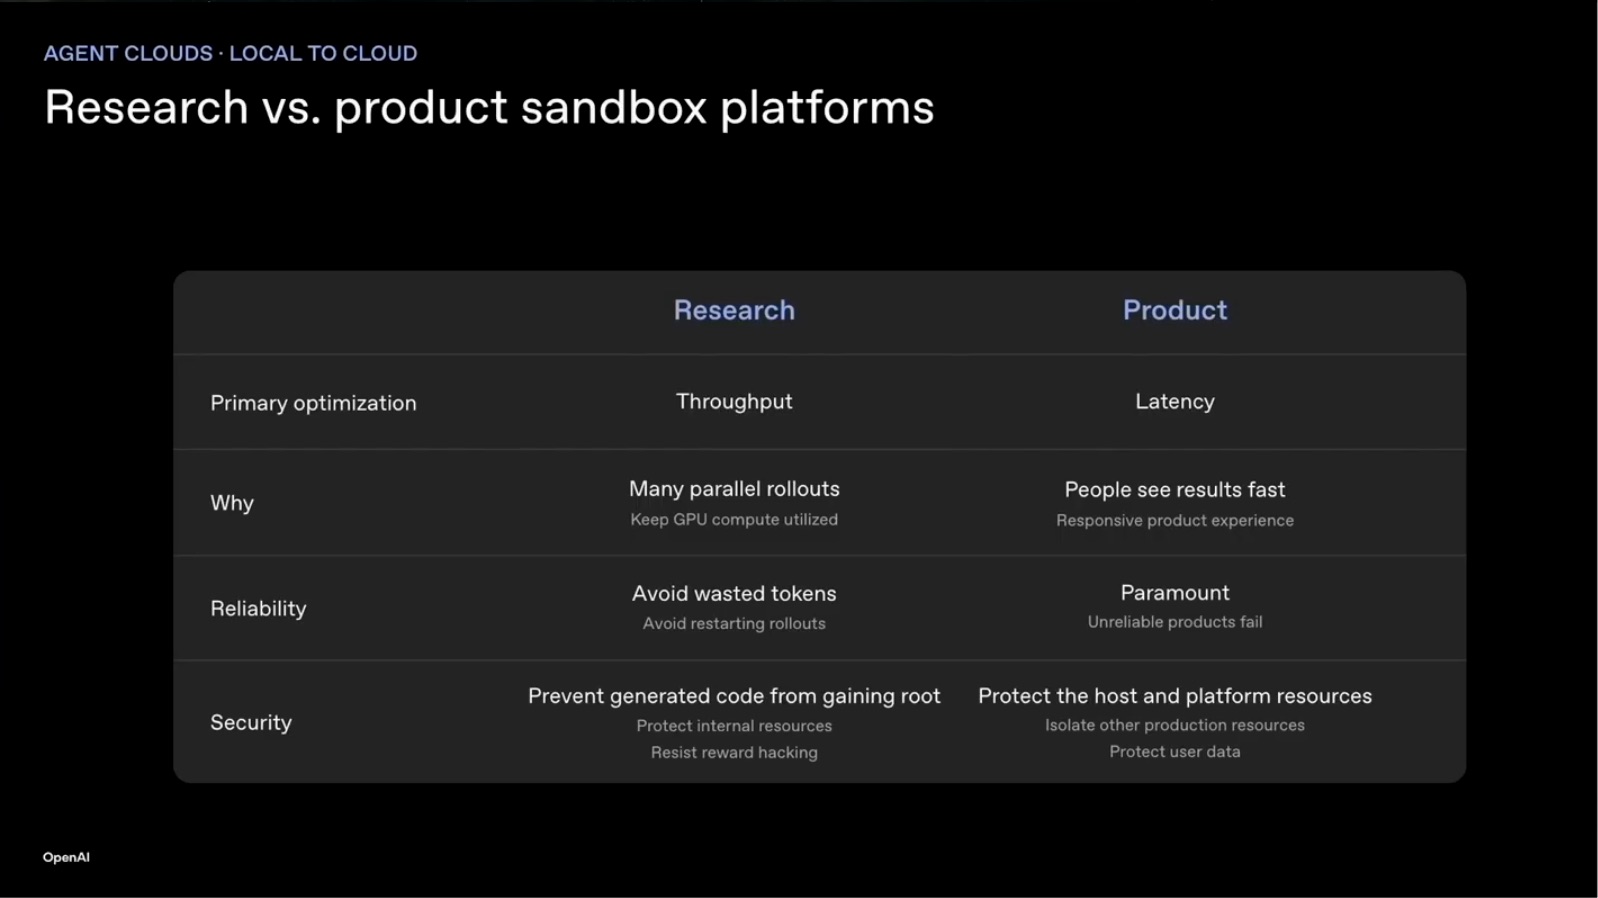
训练侧重视吞吐量,希望并行运行大量 rollout。一个 rollout,就是模型对同一任务的一次完整尝试。
产品侧更重视延迟,沙箱启动和工具执行都必须足够快。可靠性和安全性则是共同底线:失败会浪费 GPU,生成代码还可能尝试取得 root、攻击奖励系统或内部资源。产品侧则还要保护宿主平台和其他用户的数据。
后面这三部分,就是在不同层次上回答这些目标和风险。现在进入总图最左边的 Runtime,从一次工具调用怎样碰到 Linux 内核开始。
第一部分|第 8 页|代码为什么能碰到内核
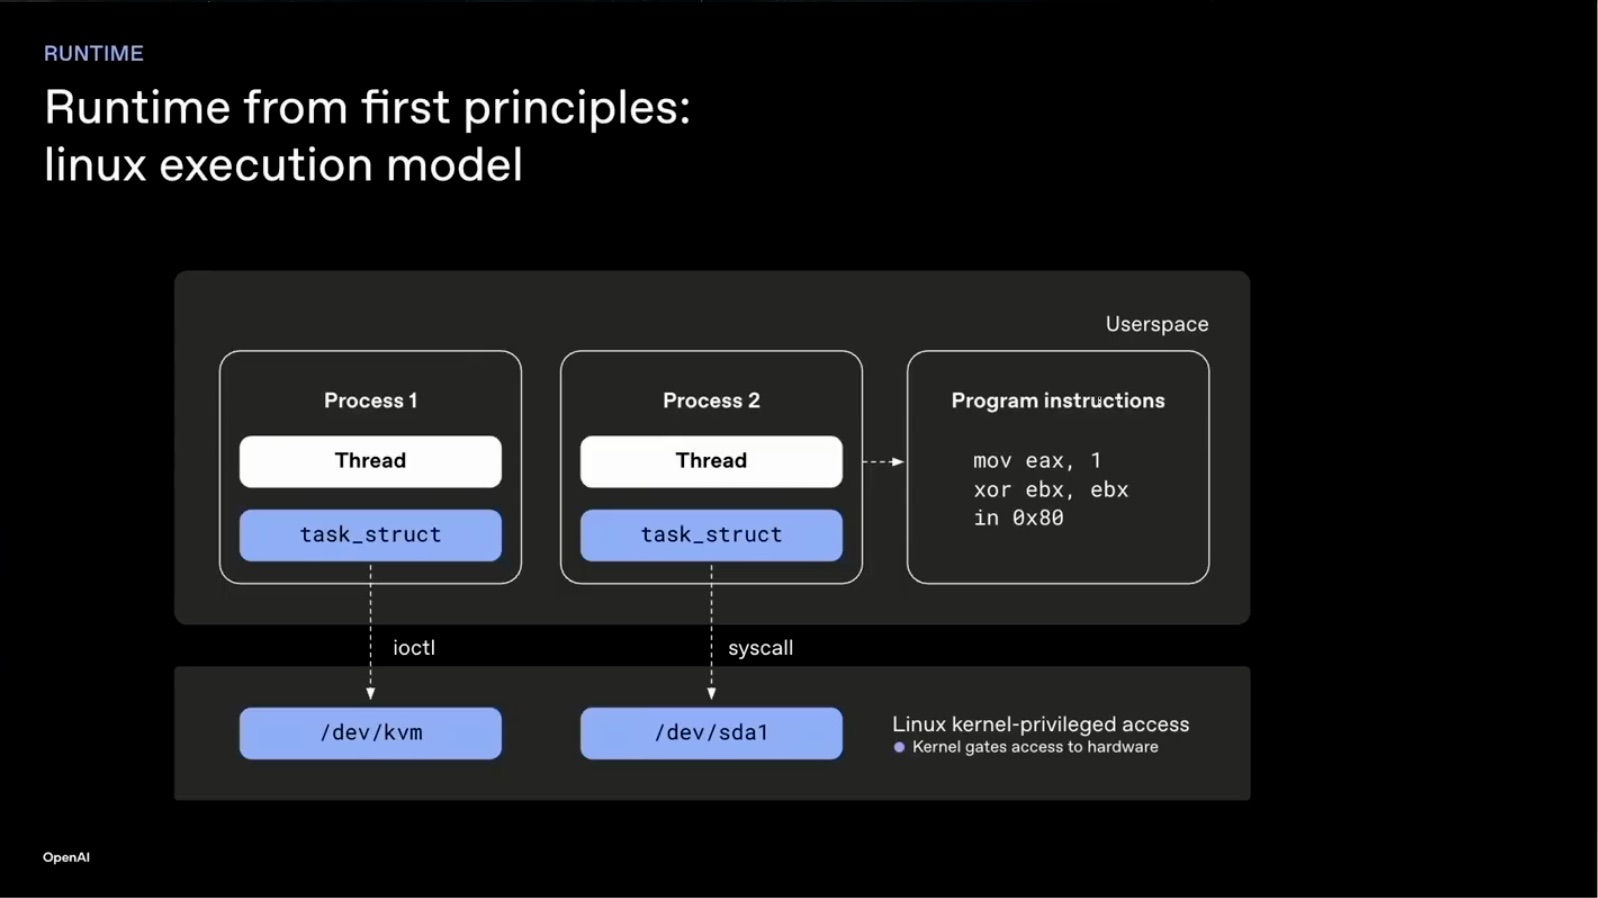
普通程序运行在用户态。它要读文件、访问网络或操作硬件,必须通过 system call 或 ioctl 请求内核提供服务。
后面几种沙箱方案的主要区别,就是不受信任代码离宿主机内核有多近,中间隔了多少层。
所以接下来先分清两种风险:拿到 root,和真正进入内核,并不是一回事。
第 9 页|root 和内核漏洞
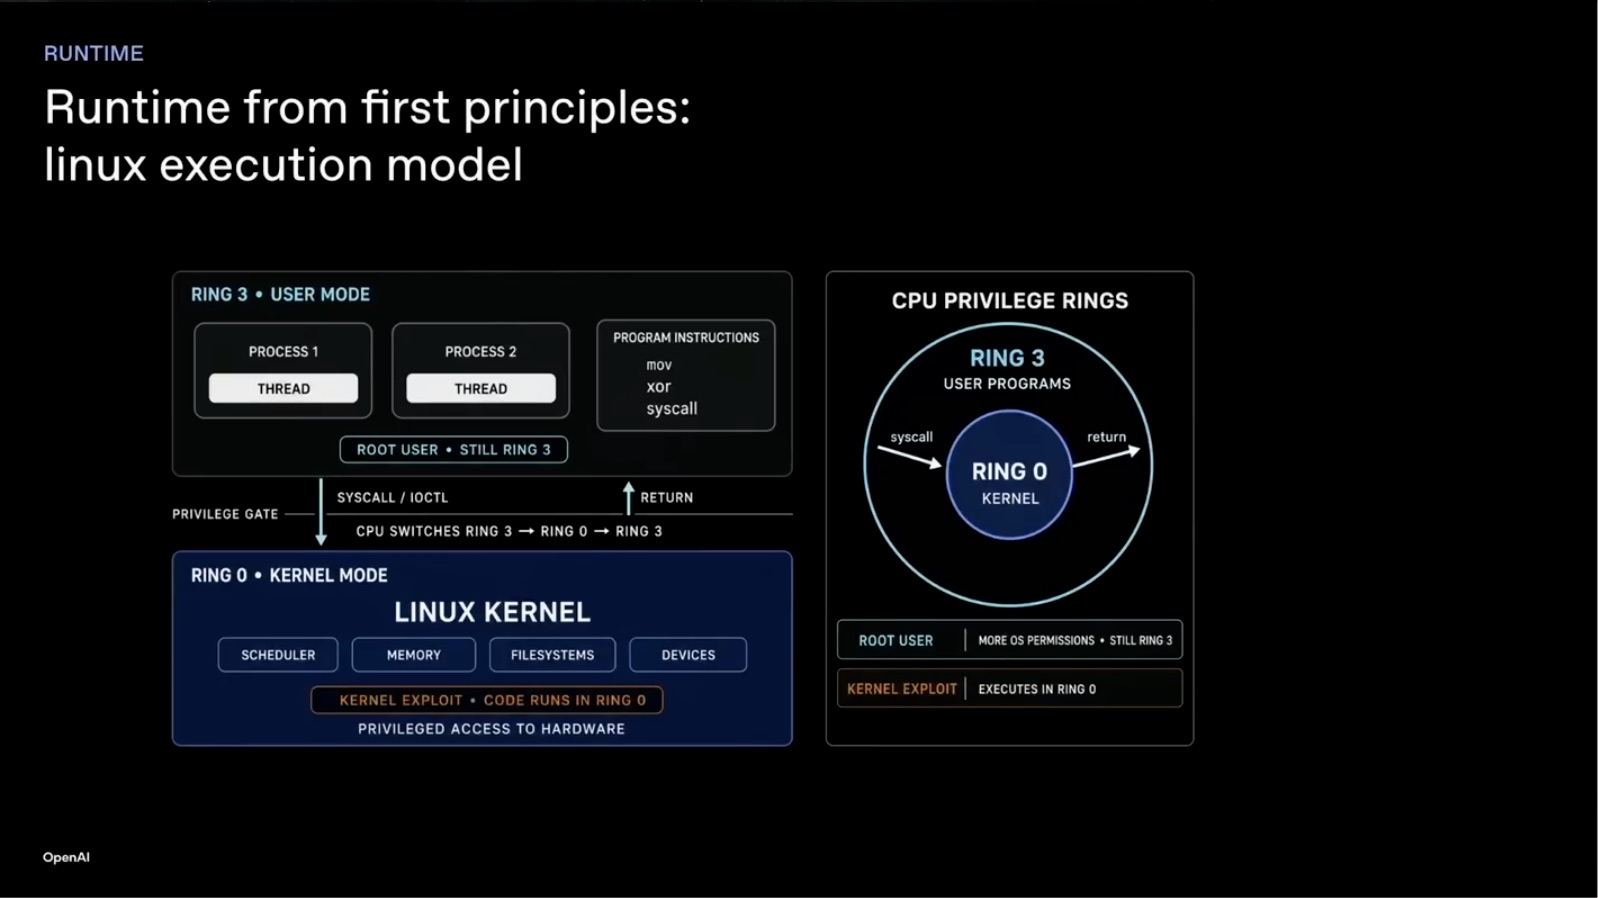
这页把系统调用路径和 CPU 权限环放在一起。用户程序通常运行在外圈的 ring 3,内核运行在中心、权限最高的 ring 0。
取得 root,意味着成为用户空间里的最高权限用户;利用内核漏洞,则可能直接控制整个系统。Agent Sandbox 需要同时防范这两条路径。
有了这两个攻击目标,就可以检验最简单的执行方案。
第 10 页|最简单的 fork/exec
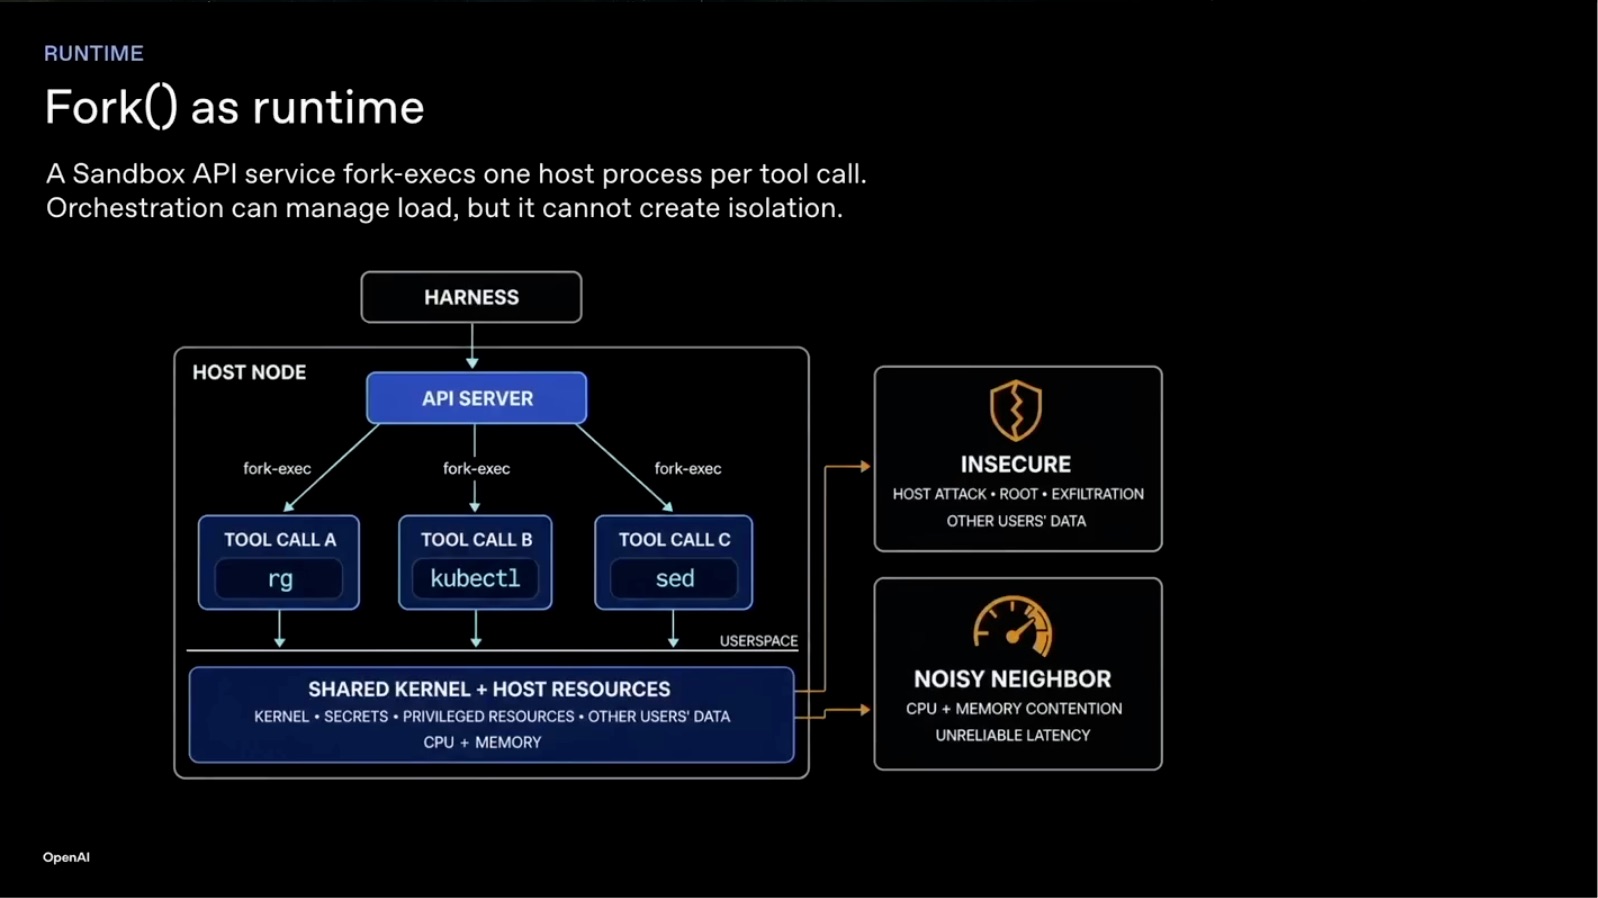
最简单的工具执行方式,是 Harness 把请求交给 API Server。API Server 每收到一次调用,就 fork 一个进程,再用 exec 运行命令。三次 tool call,就是宿主机上三个原生进程。
它接近原生性能,但新进程可以直接调用宿主机内核。一个不断创建进程的循环,还可能耗尽整台机器的 CPU 和内存。调度可以重新分配负载,却不能替这些进程创造隔离边界。原生性能几乎是它唯一的优势。
于是第一步不是换掉进程,而是给这些进程增加隔离视图和资源上限。
第 11 页|从进程走向容器
图中的多个 container 仍然运行在同一台主机上。容器增加了两类能力:namespace 隔离进程看到的资源,cgroup 限制一组进程能够消耗多少资源。
它解决了相互可见和 noisy neighbor 问题,但还没有换掉宿主机内核。
要理解这句“还没有换掉”,先把容器的两个底层部件拆开看。
第 12 页|容器图要表达什么
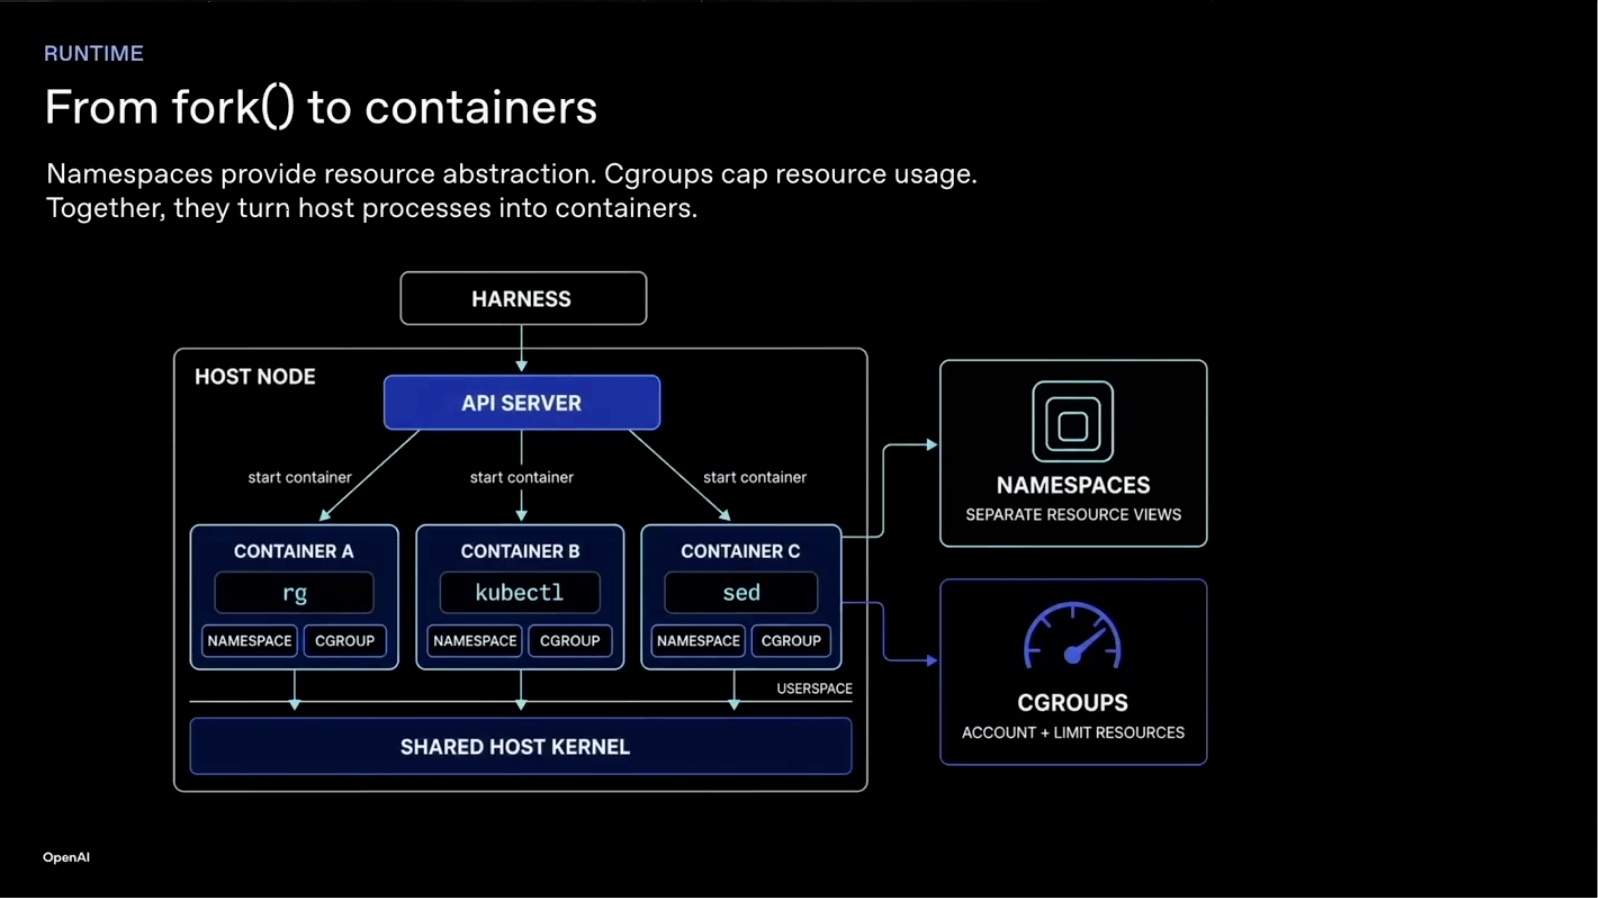
上半部分是 PID namespace。同一批进程,在容器里显示为 PID 1、2、3,在宿主机里可能是 100、101、102。
下半部分是 mount namespace。同一个宿主机目录,可以在容器里显示成另一条路径。
所以容器隔离的是资源视图。它很轻,是因为这些进程仍然共享宿主机内核。
视图已经分开了,接下来还要限制每个容器能消耗多少资源。
第 13 页|cgroup 管能用多少
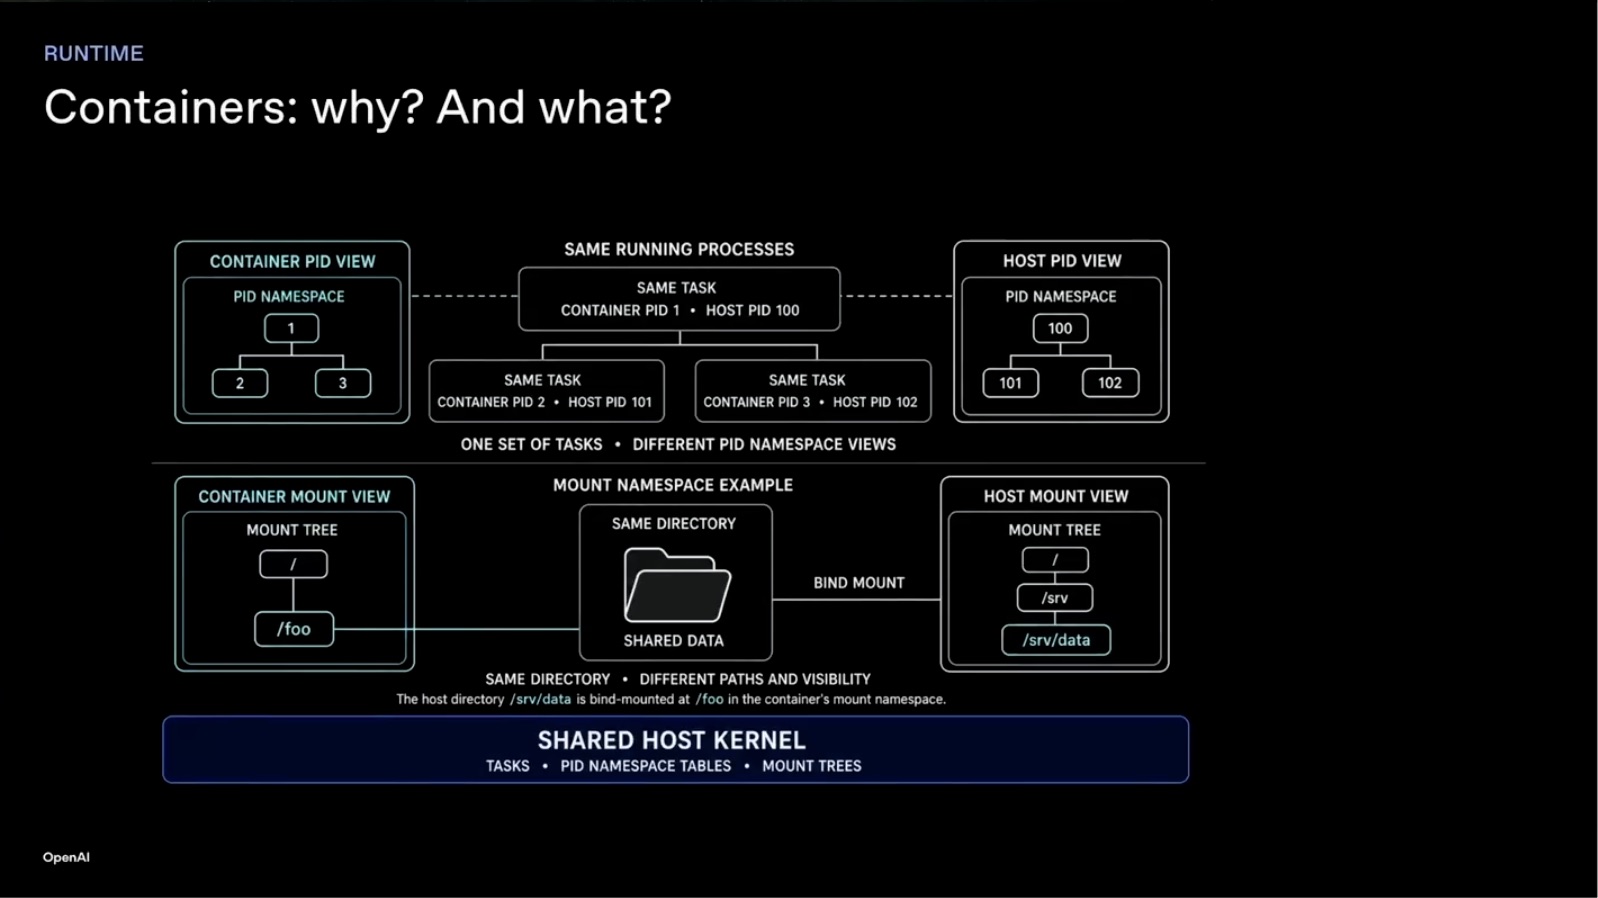
namespace 给每个容器提供独立视图,cgroup 则给它设定 CPU、内存和 I/O 配额。
即使某个 Agent 写出死循环或不断创建进程,它也不应该拖垮同一节点上的其他任务。
到这里,资源视图和资源配额都有了。但安全边界还剩最后一层:所有容器仍然走向同一个内核。
第 14 页|容器仍然共享内核
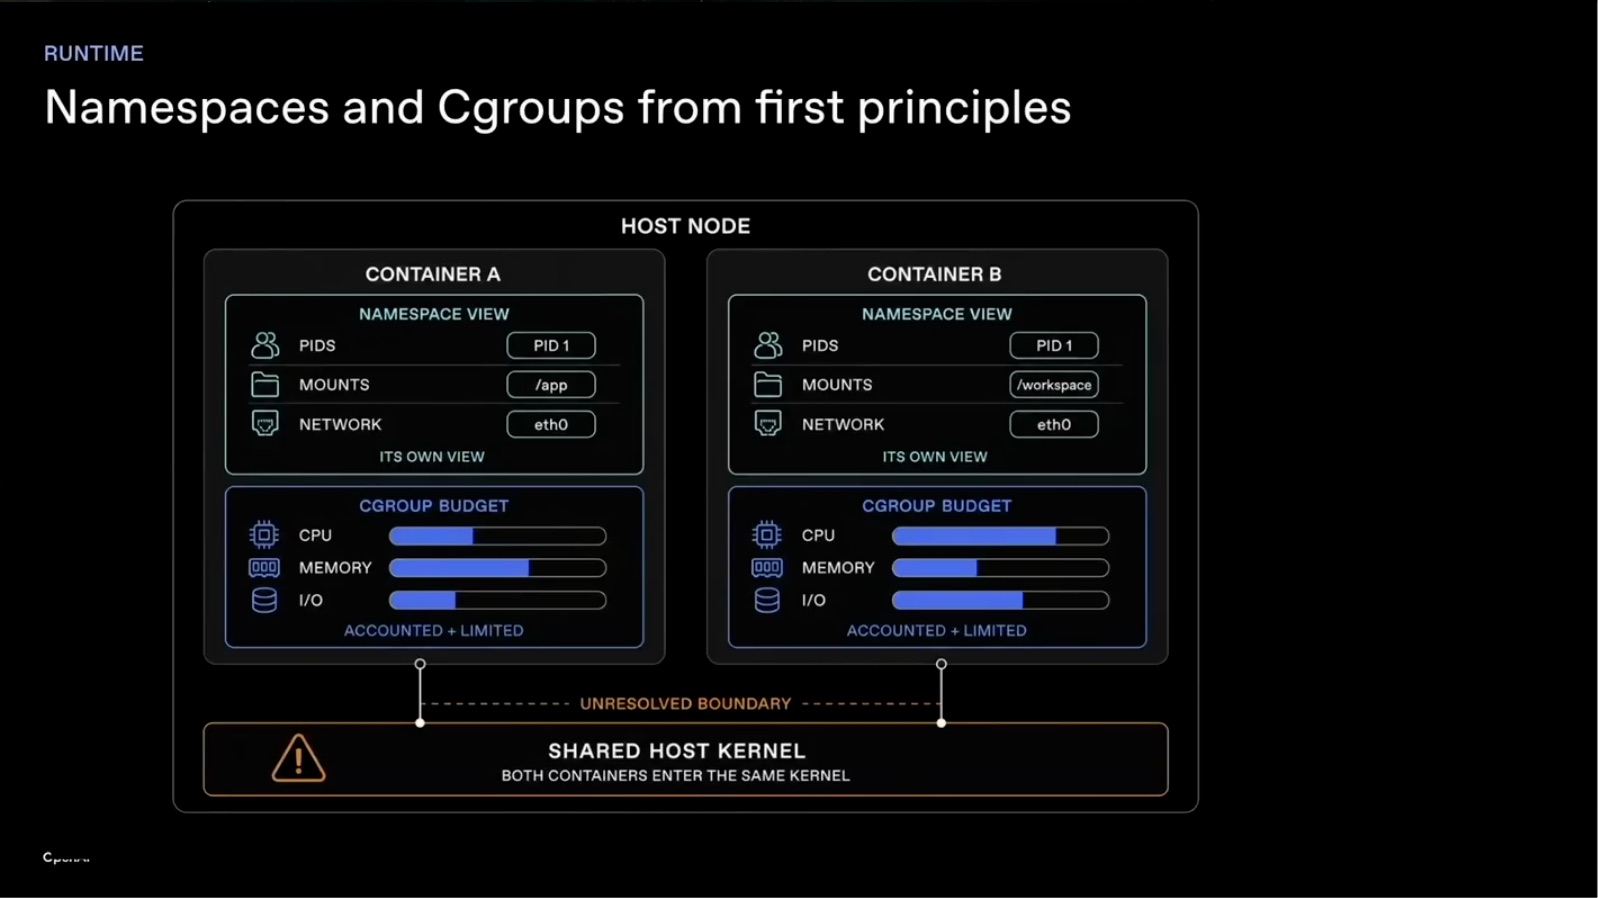
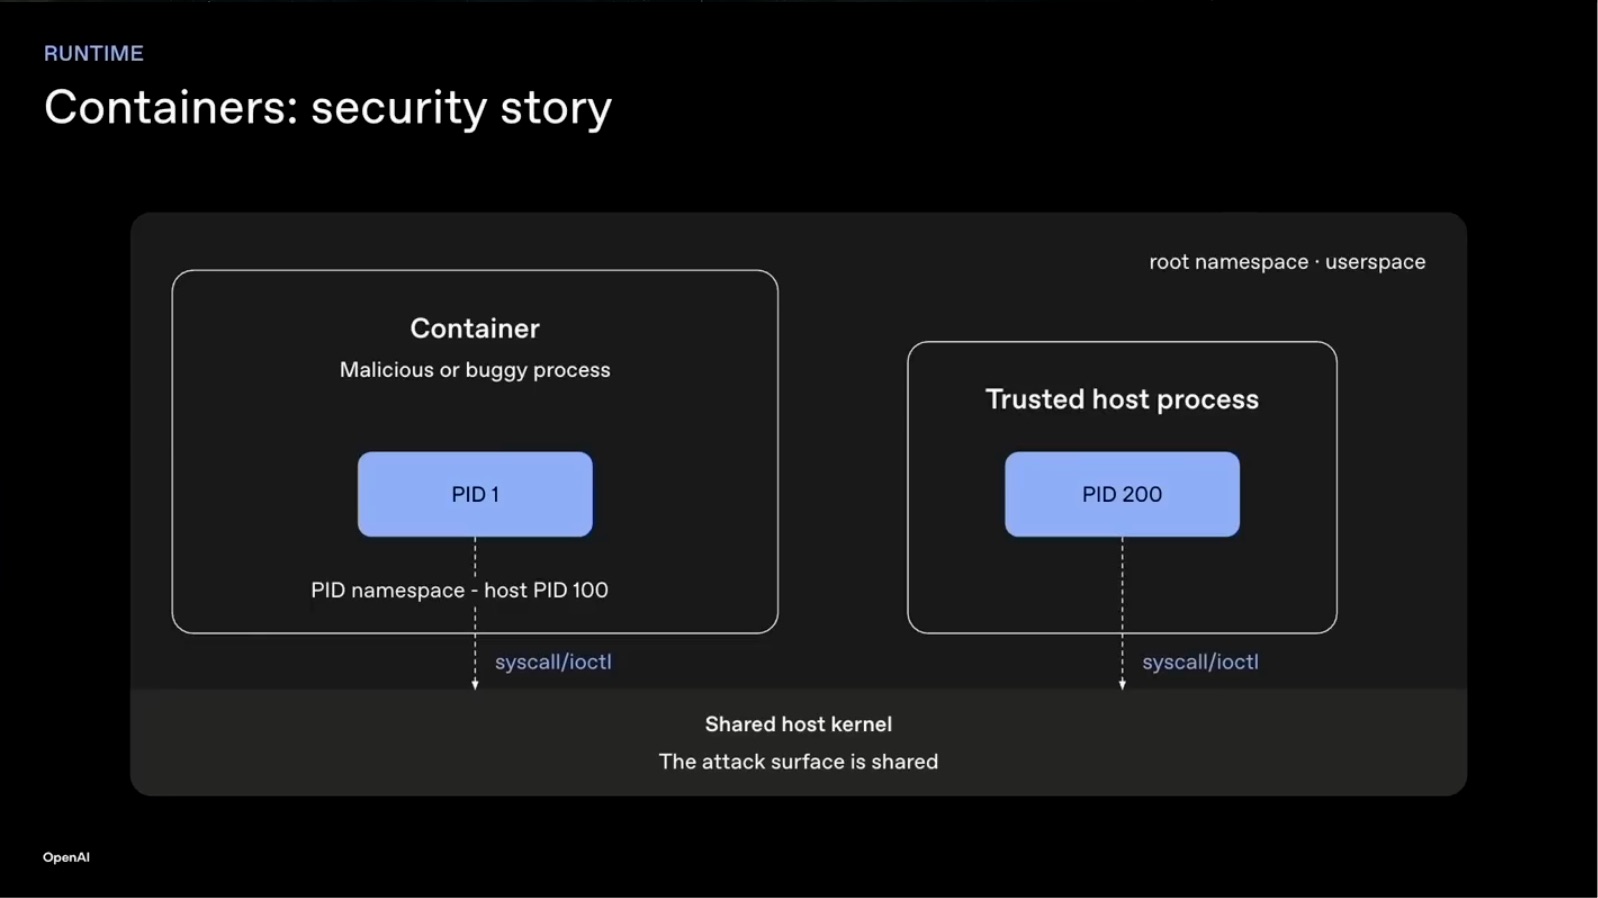
恶意容器和宿主机上的受信任进程,最终都会调用同一个 host kernel。
图里的恶意容器和受信任进程,都要跨过同一块内核攻击面。namespace 改变了它们看到的资源,却没有把它们放到不同的内核边界里。
容器不能消除这条路径,只能先尽量缩小暴露给代码的内核接口。
第 15 页|seccomp 缩小攻击面
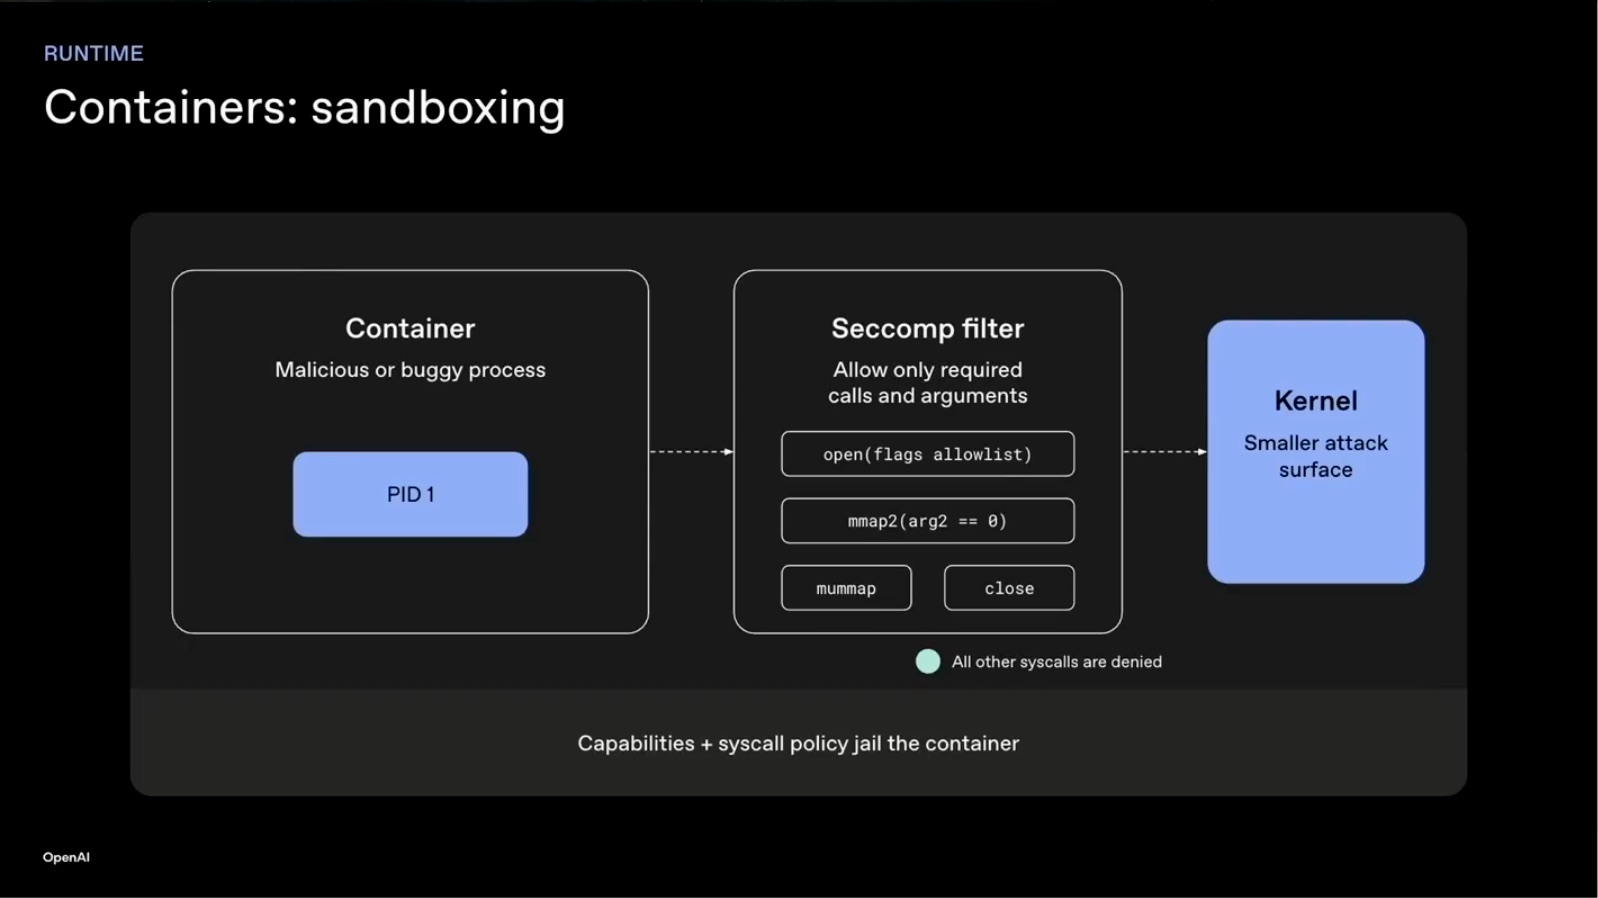
seccompfilter 会检查容器发出的 syscall是否在 allowlist 里,通过才能到达内核。规则还可以约束调用参数。
但通用 Agent 会安装包、编译代码、调用各种工具。规则太严,正常任务无法运行;规则太松,攻击面又会扩大。
这就形成了容器方案最难处理的取舍。
第 16 页|容器的根本取舍
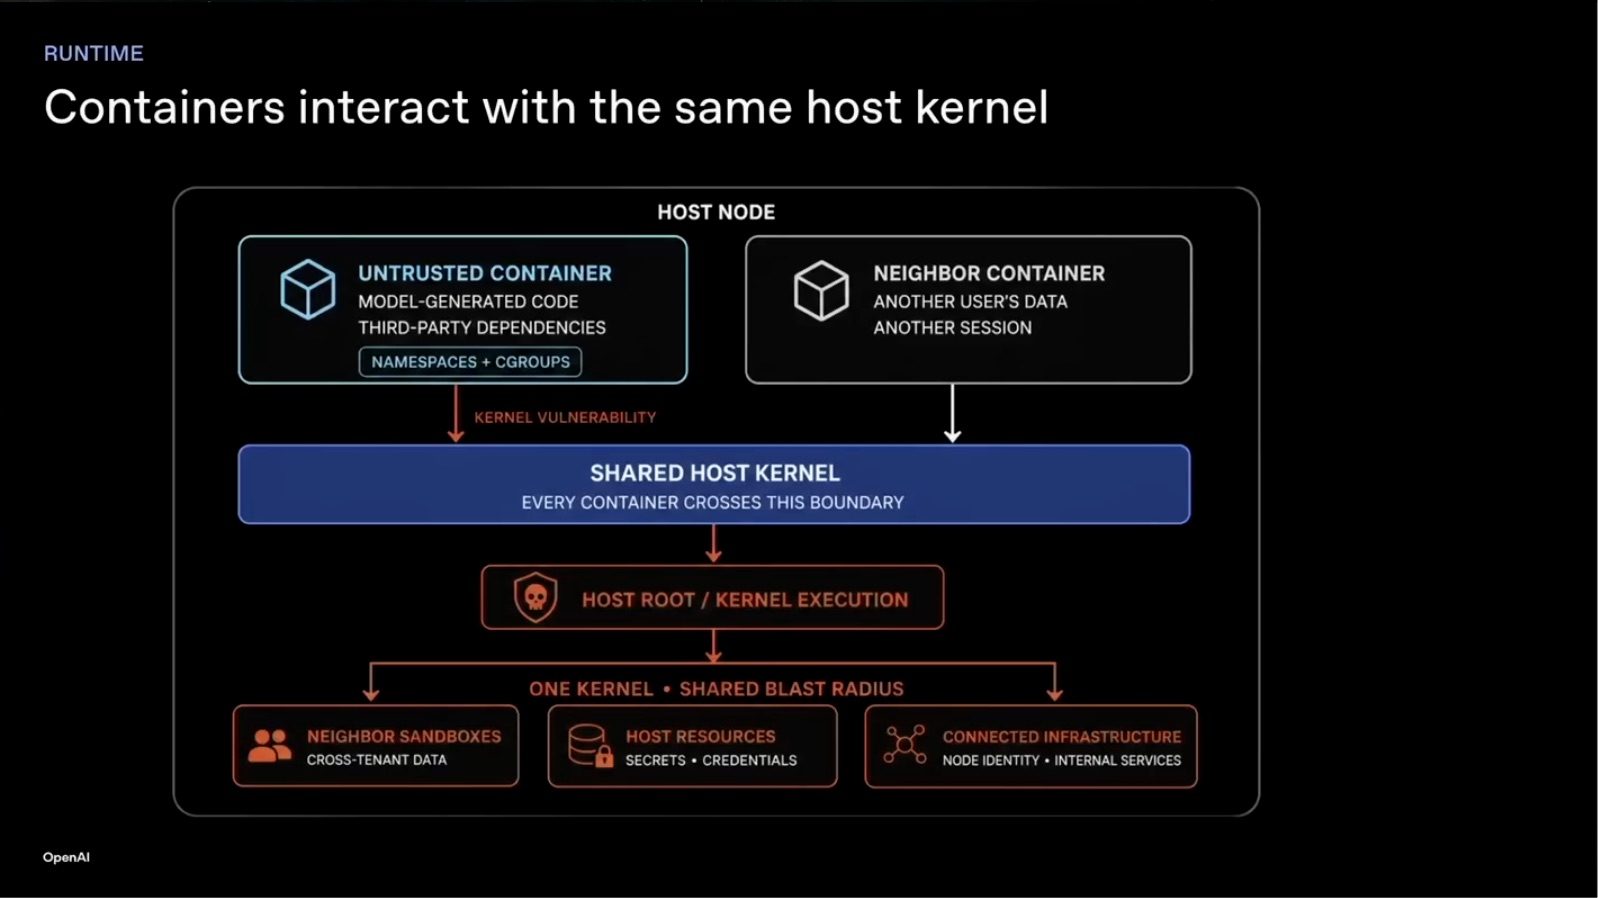
seccomp 能减少暴露出来的 syscall,但对于能力不断变化的 Agent,平台很难预先知道全部合法调用。因此容器的安全与兼容性紧密绑定:放开接口会扩大攻击面,收紧接口又会限制 Agent 能力。
图上方的两个容器都指向共享内核。如果攻击者拿到宿主机 root 权限,甚至通过漏洞在内核中执行代码,影响会扩散到其他用户的沙箱、宿主机 secrets和 credentials,以及与节点相连的内部服务。
这就是共享内核真正没有解决的 blast radius。
到这里,可以把 fork 和 container 放在同一条线上做一次小结。
第 17 页|从 fork 到容器
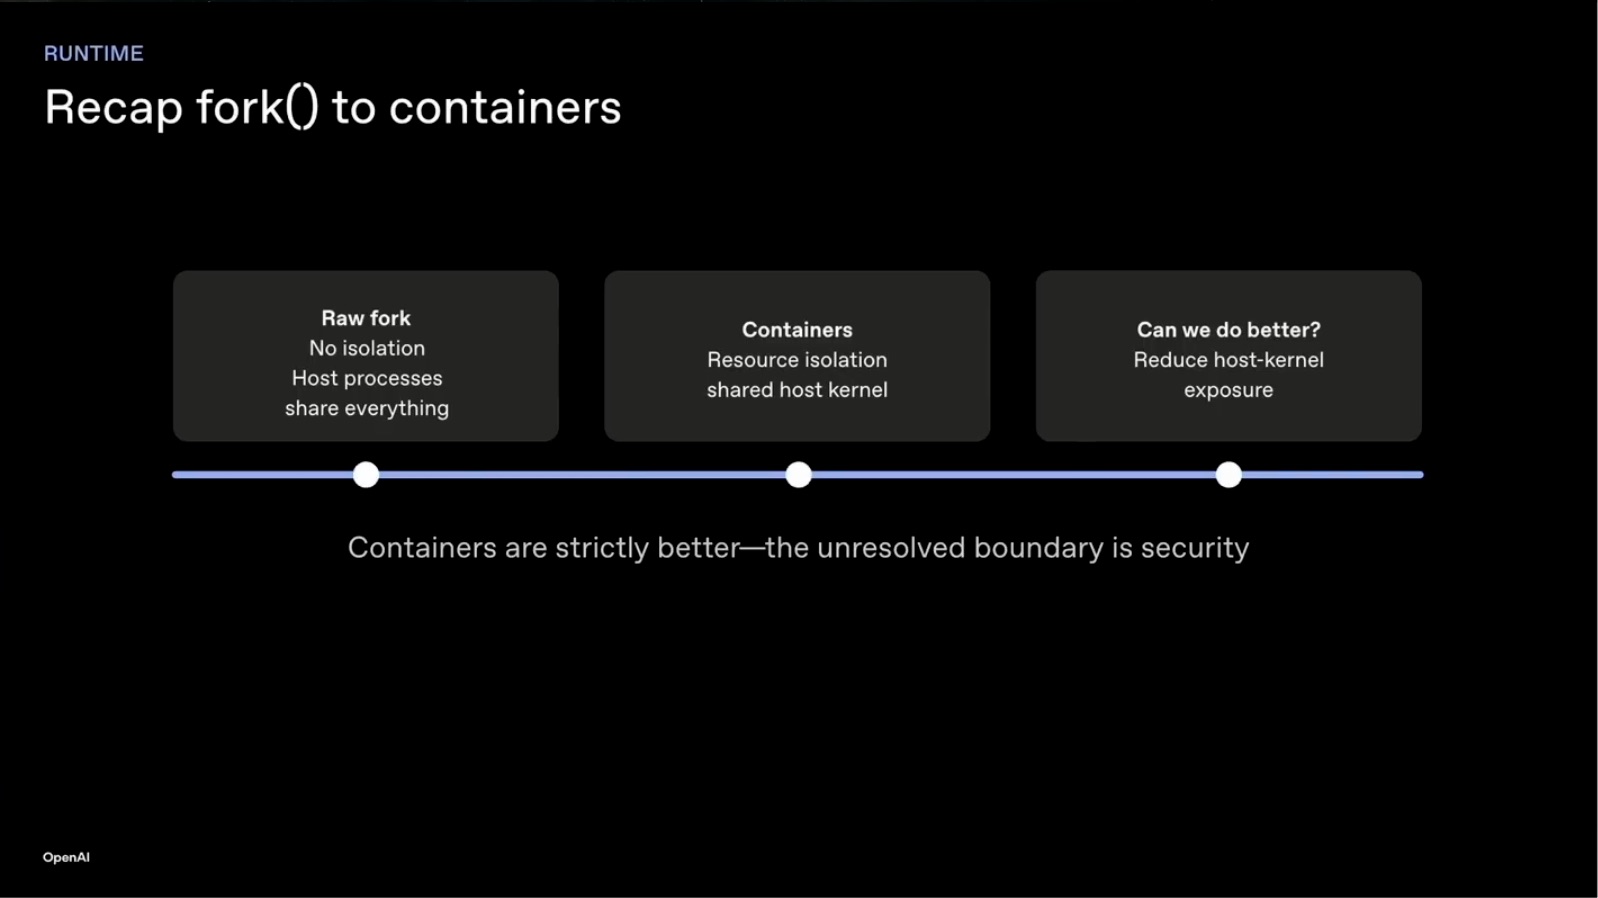
这张时间线把方案连起来:裸 fork 只有原生性能;容器增加了资源视图、配额和 syscall 过滤,安全性明显更好。
但两者都没有改变一个事实:不受信任代码最终仍能接触宿主机内核。
下一步,gVisor(G-维泽)不再只过滤 syscall,而是尝试在用户态接住它们。
第 18 页|gVisor 的应用内核
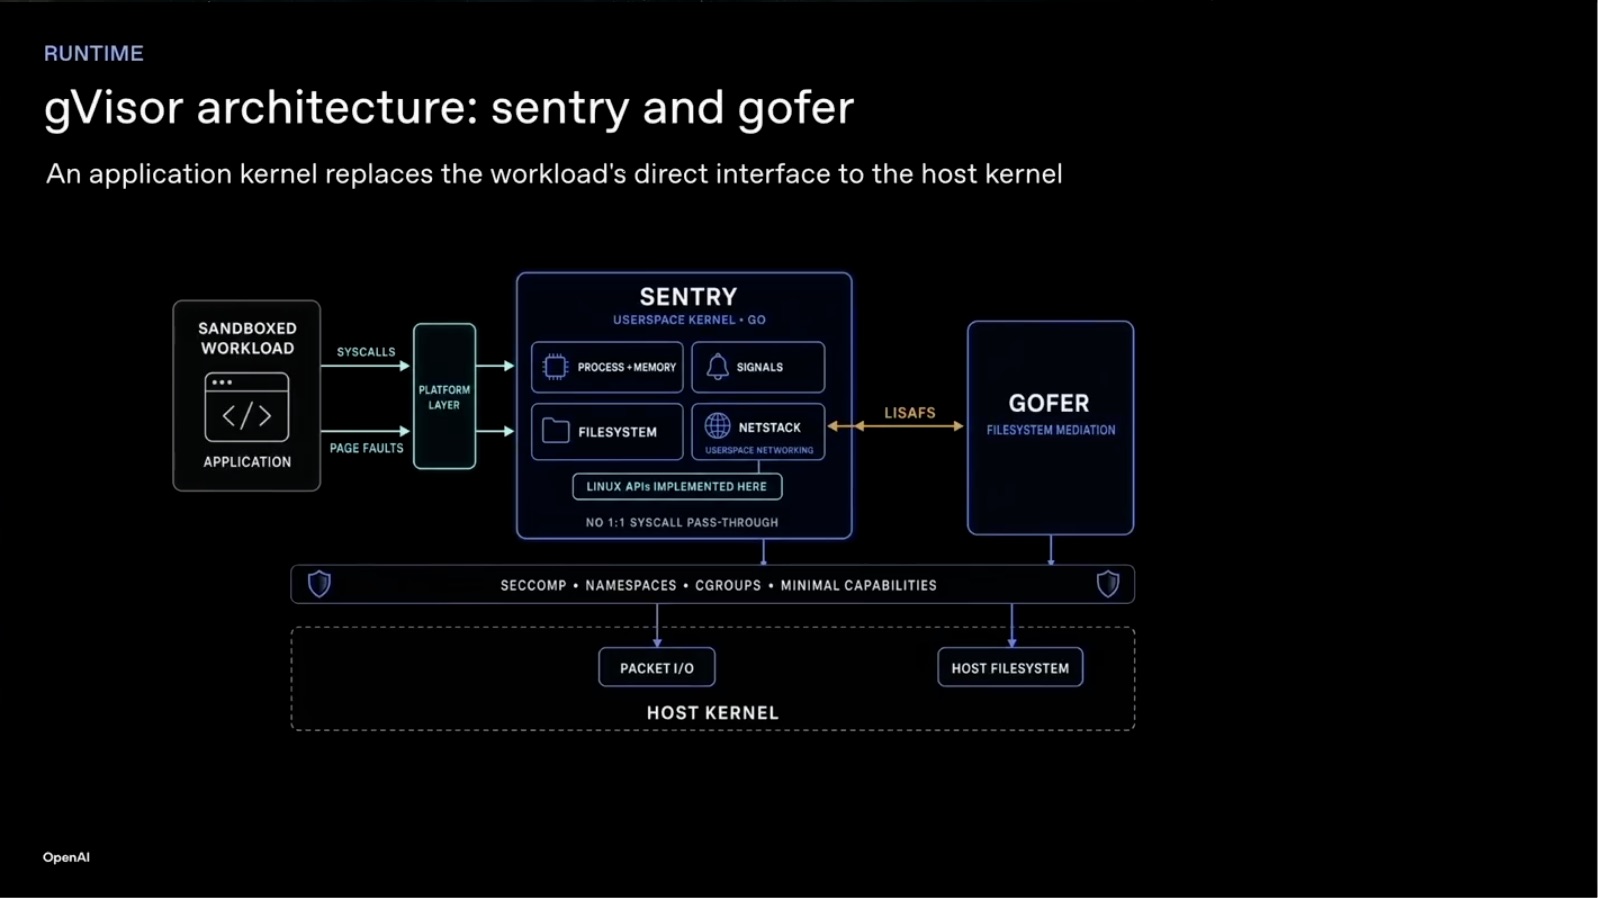
这页仍然从左往右看。左边是不受信任的 workload;它的系统调用先进入中间的 Sentry。Sentry 在用户态实现大量 Linux syscall,文件访问则交给右边的 Gofer等组件。最下方才是 host kernel。
攻击者首先面对的是 ring 3 的用户态组件,而不是直接进入 host kernel。
这比容器多了一道门。不过,这道门后面是不是已经没有宿主机内核了?
第 19 页|gVisor 留下的路径
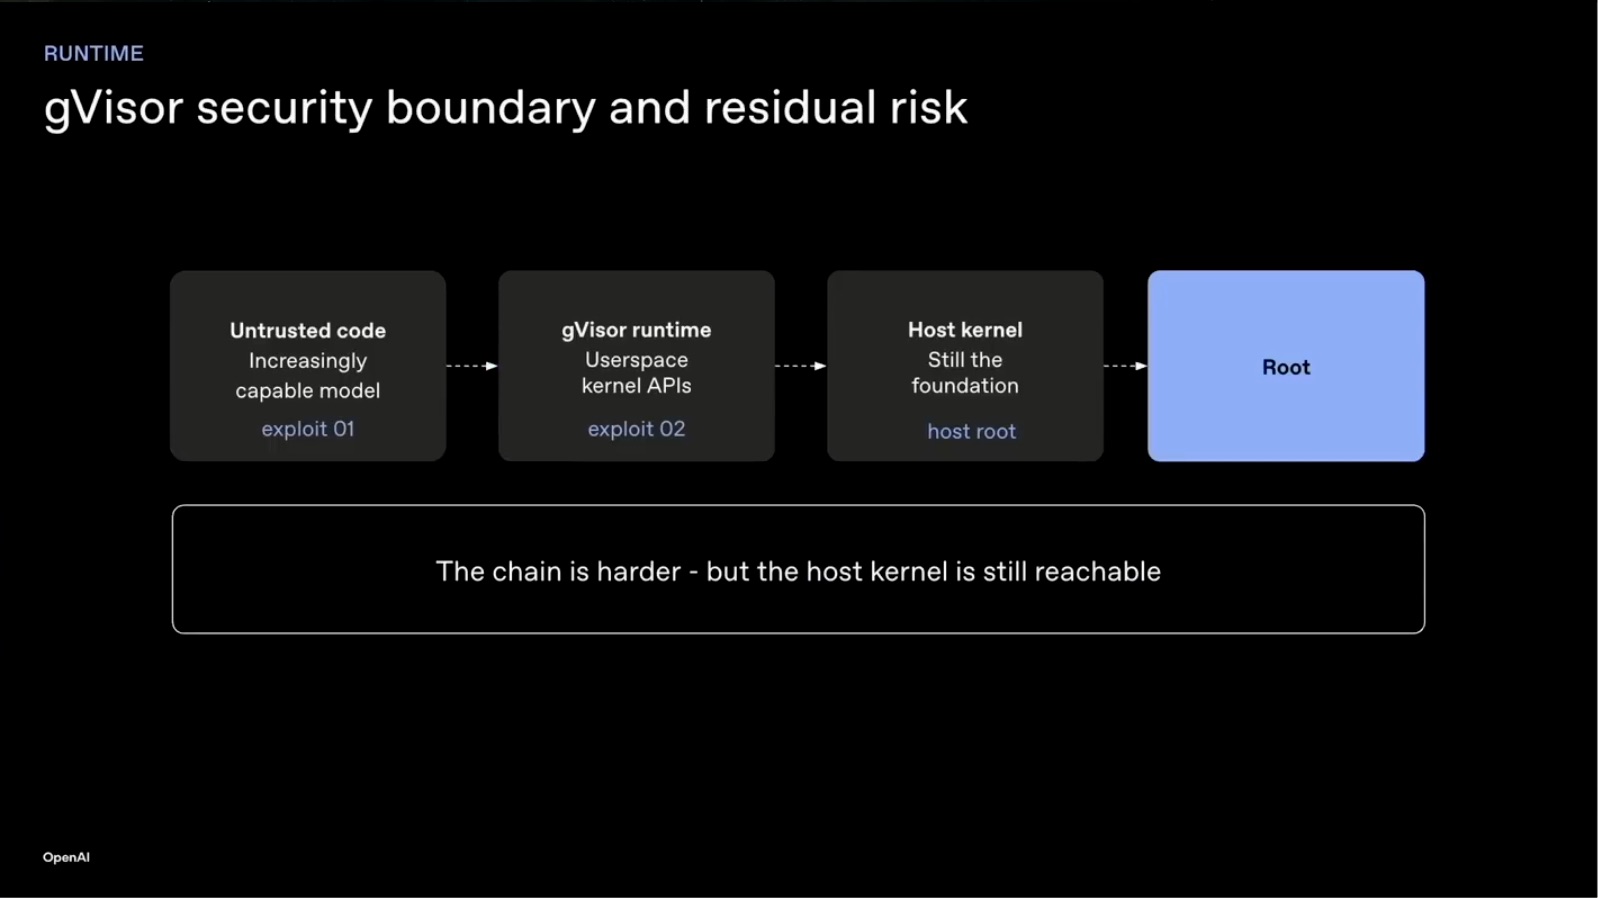
Sentry 和 Gofer 最终仍运行在宿主机内核上。
攻击者可以先突破 Sentry 或 Gofer 这些用户态组件,再继续攻击 host kernel。攻击从一步变成两步,难度更高,但路径仍然存在。
下一页重新回到架构图,看这条两步攻击链具体落在哪里。
第 20 页|再看一次调用链
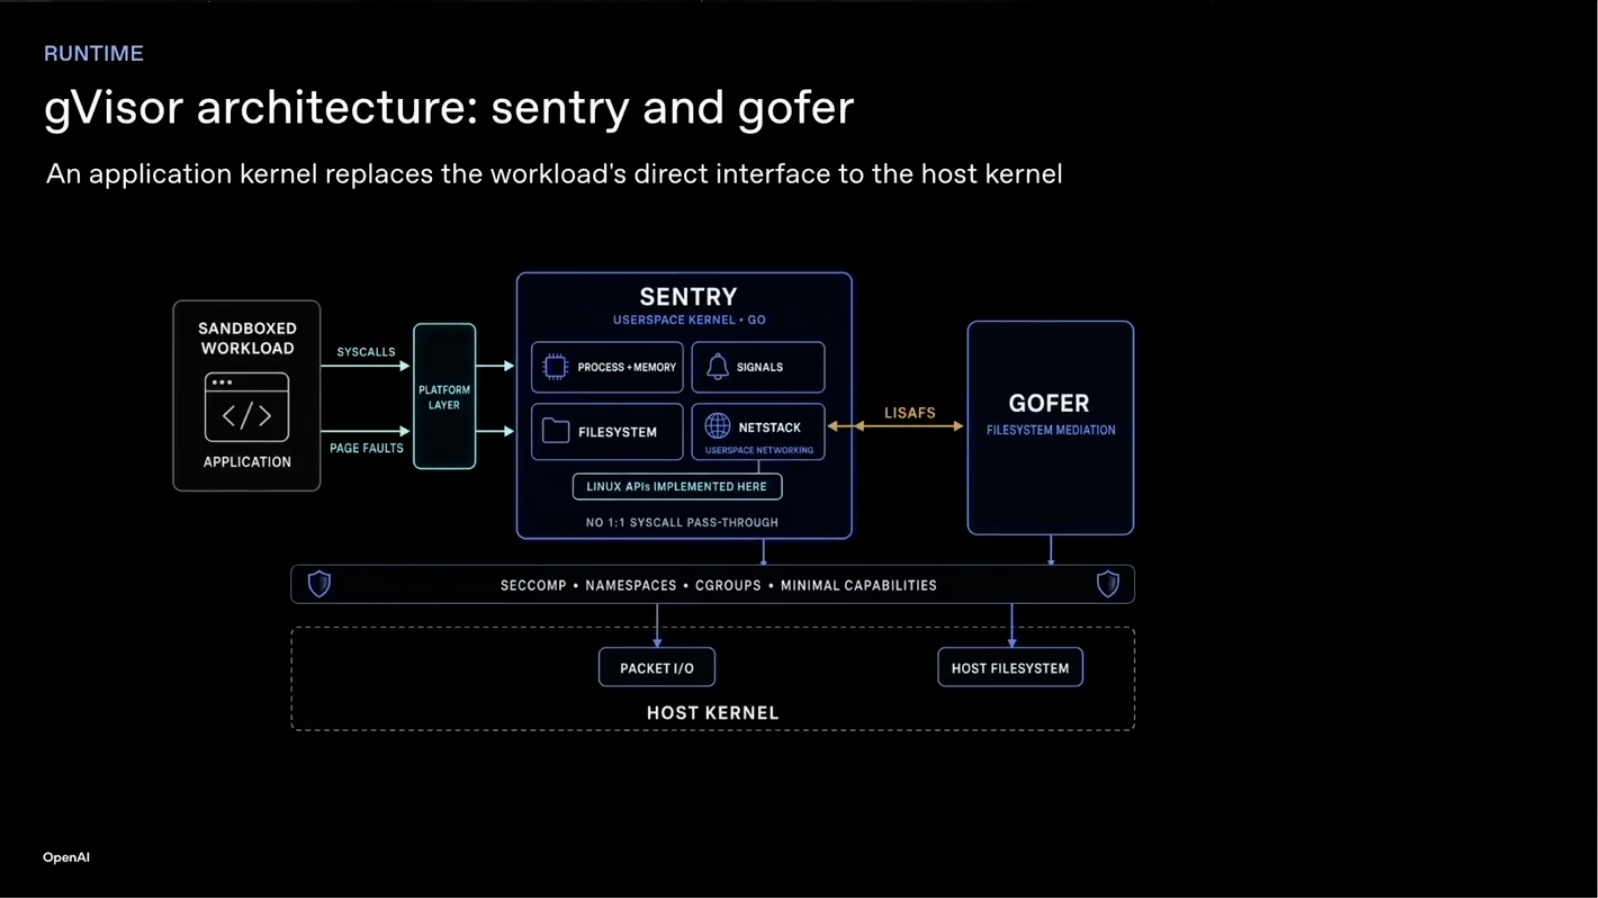
这一页回到刚才的架构图。这次沿着系统调用的路径看:应用先到 Sentry,文件类请求经过 Gofer,这些用户态组件最终仍运行在下方的宿主机内核上。
gVisor 的价值,是减少应用直接接触的 host kernel API,并把第一道攻击放在用户态;它没有让宿主机内核彻底消失。
所以这里衡量的不是“绝对安全”,而是攻击者要连续跨过多少层。
第 21 页|安全是一条光谱
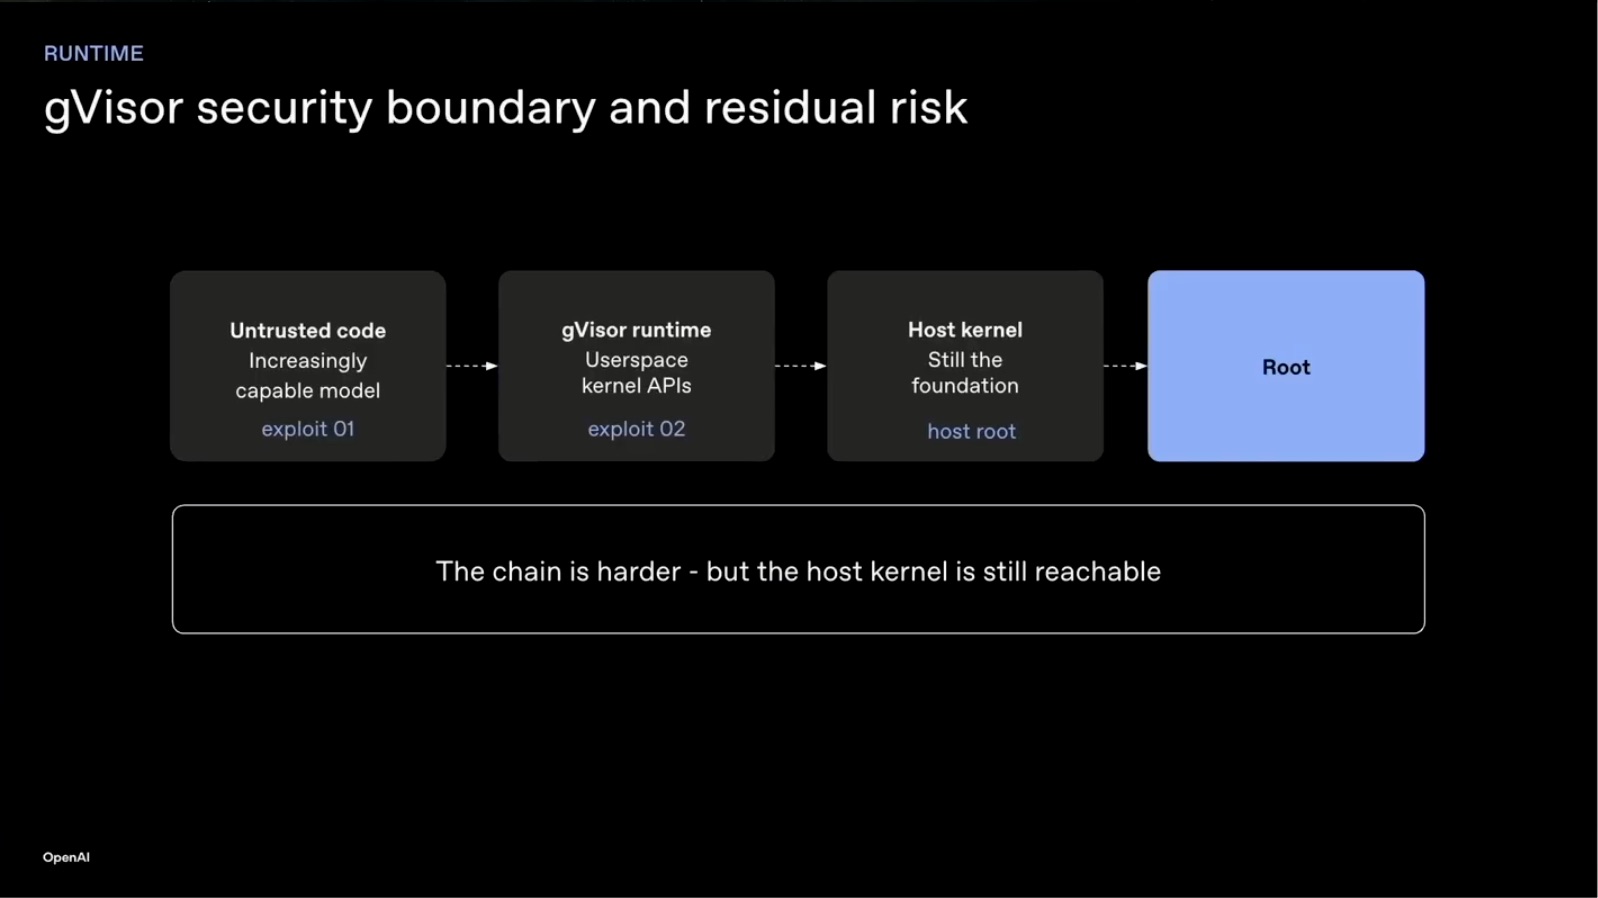
fork、container 和 gVisor 不是简单的安全与不安全。
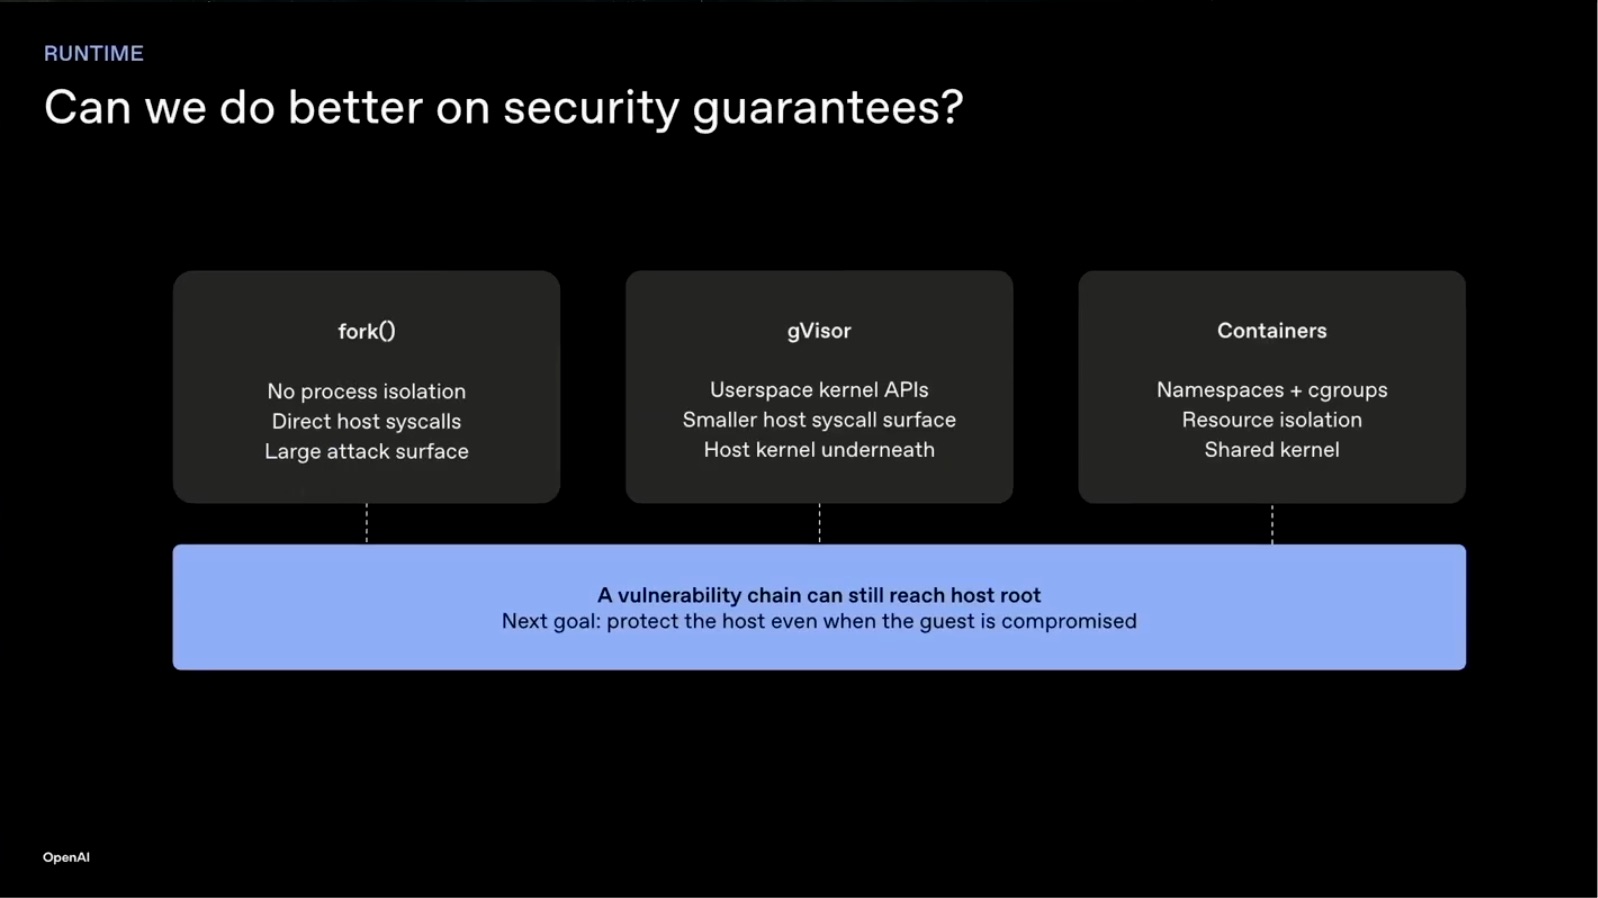
每增加一层,攻击链都会变长;但这三种方案最终仍可能到达 host kernel。下一步需要的,是一条独立于宿主机内核、即使 guest 自己被攻破也能继续保护 host 的边界。
第 22 页|guest 被攻破,host 还能安全吗
Abhishek 接下来提出的问题是:即使不受信任代码在自己的环境里拿到 root,甚至攻破自己的内核,宿主机能不能仍然受到保护?
CPU 提供的硬件虚拟化,就是他给出的答案。
它与容器最关键的差别,是 guest 不再直接共享 host kernel。
第 23 页|硬件虚拟化的边界
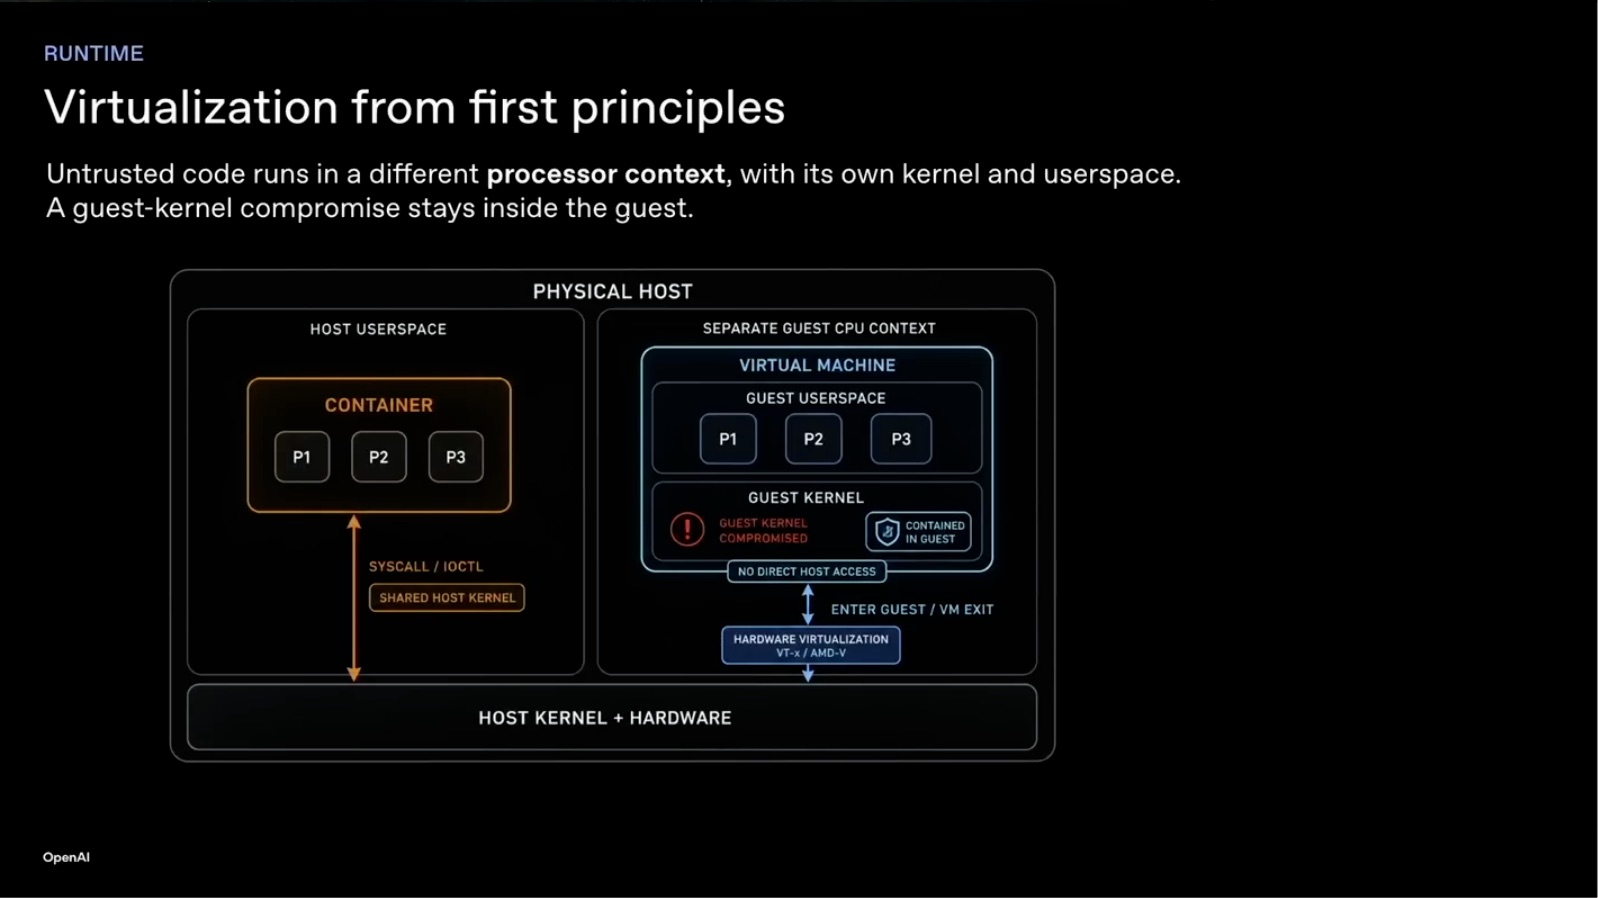
左边的容器内部没有独立内核,它直接调用下方共享的 host kernel。往右看,虚拟机内部有自己的 guest kernel,并运行在独立的处理器上下文。
guest kernel 位于 VMX(逐字母读 V-M-X)non-root;host kernel 和 hypervisor位于 VMX root。
所以 guest 里的 ring 0 只控制 guest,不等于 host 的 ring 0。即使 guest kernel 被突破,攻击者还要跨越硬件虚拟化边界。
边界变强以后,guest 每次访问真实资源,都必须经过一次受控切换。
第 24 页|更强隔离的代价
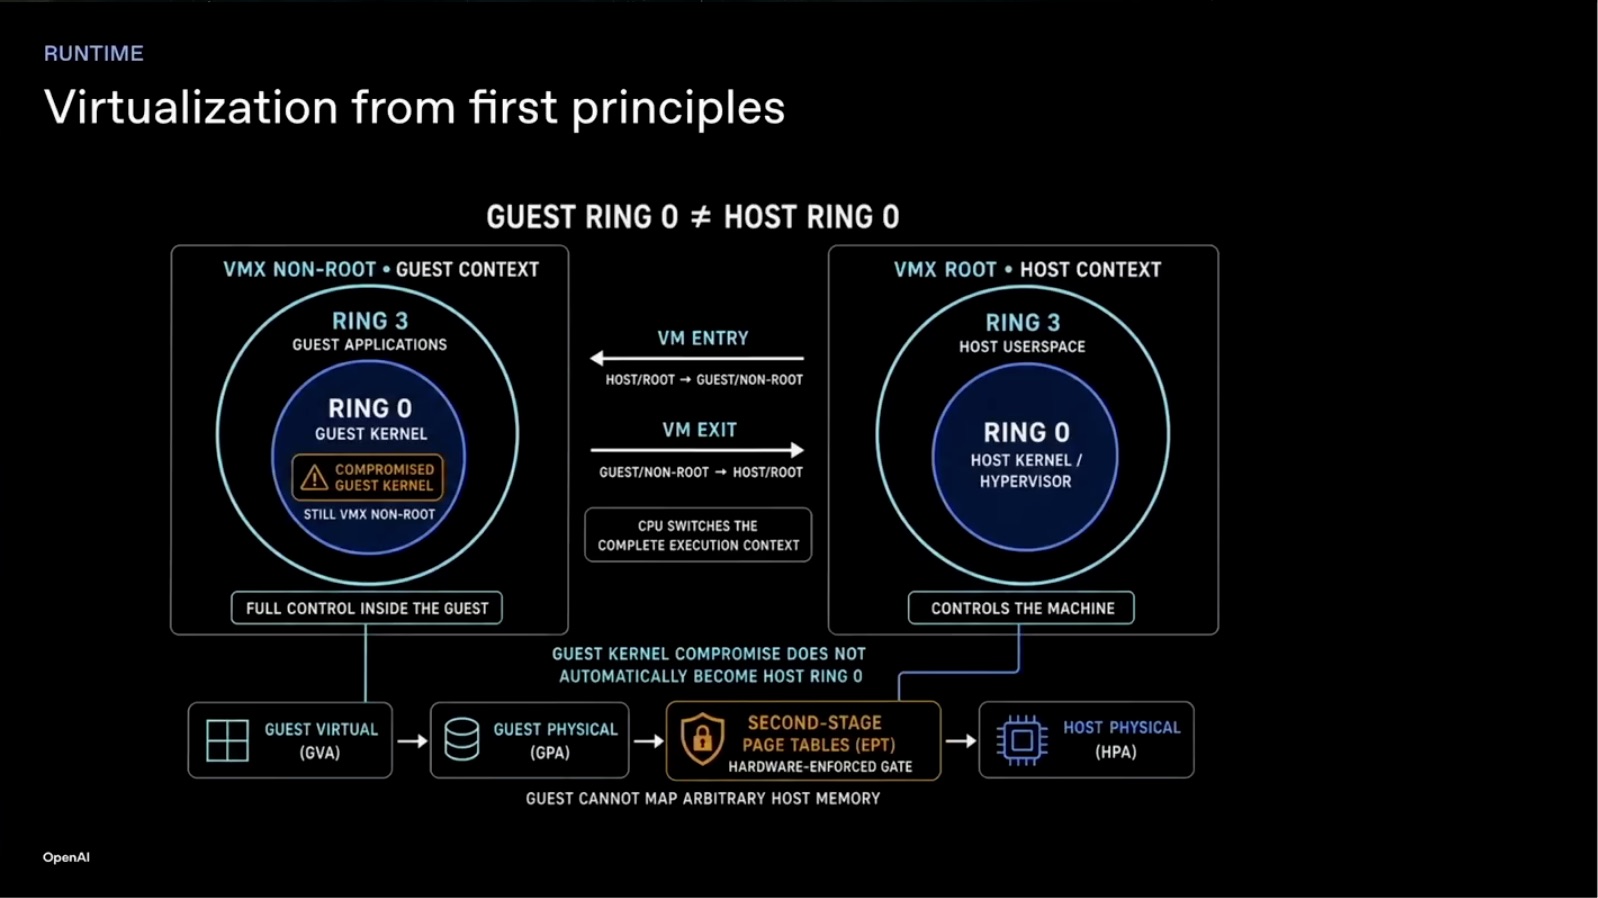
这页左边是 guest,右边是 host。guest 访问网络、磁盘等资源时,要经过中间标出的 VM exit 回到 host 处理,再通过 VM entry 进入 guest。图下方的 second-stage page tables 还限制 guest 的内存映射,不能让它随意指向 host 的物理内存。
这种上下文切换带来性能成本,但也把 guest kernel 与 host kernel 真正分开。
接下来这张图继续回答:谁负责完成这些切换,又怎样把磁盘和网络提供给 guest?
第 25 页|VMM、KVM 与 virtio
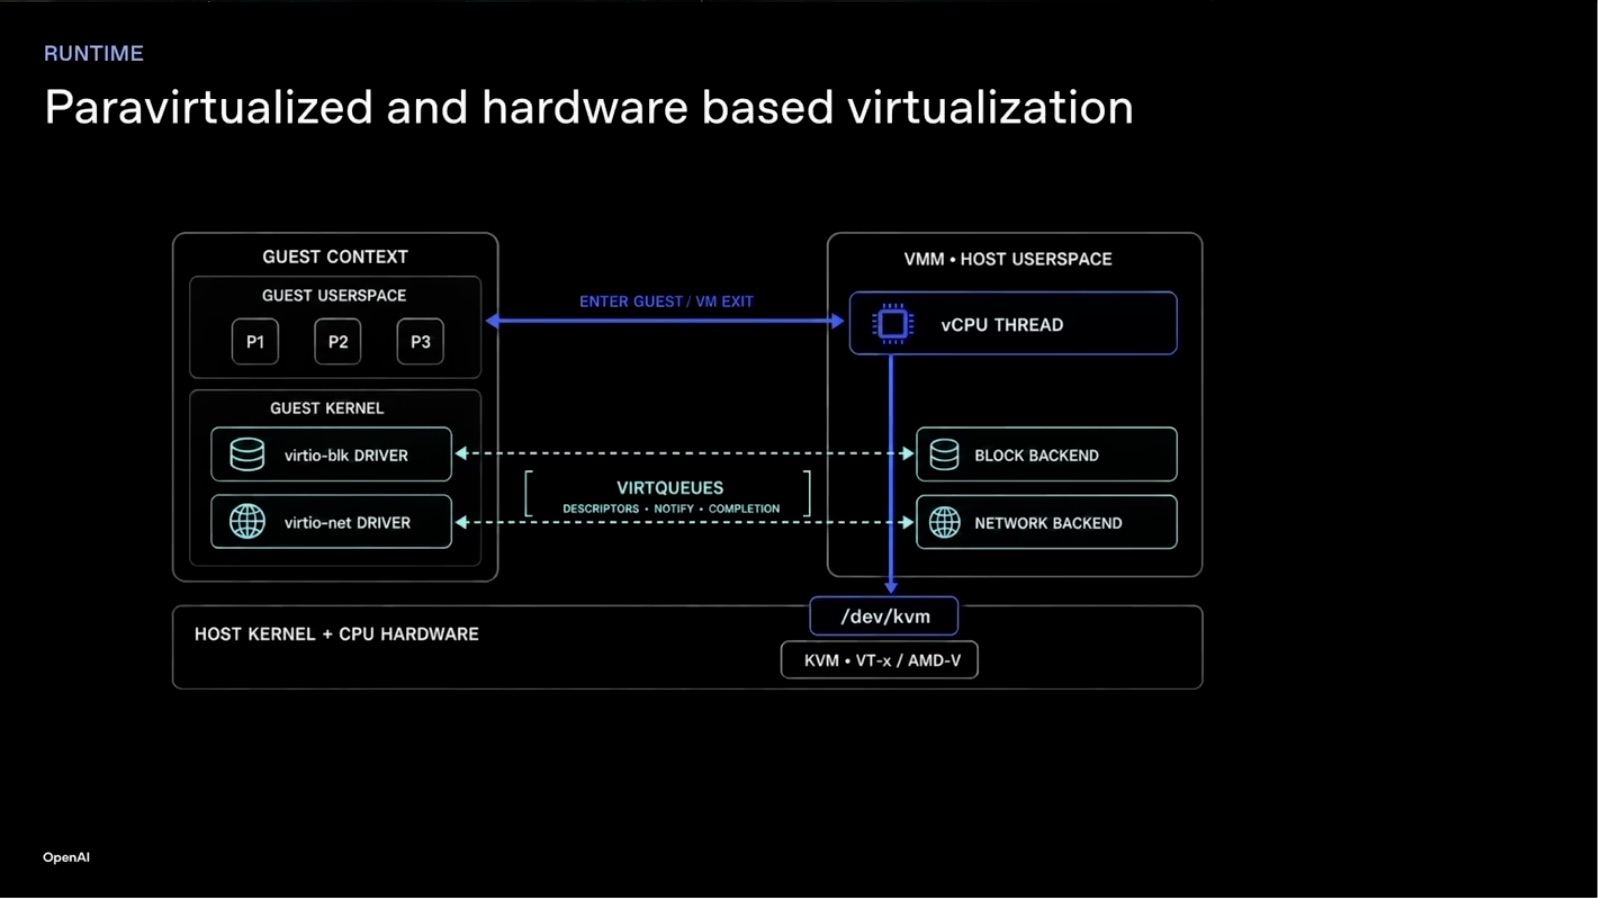
图左边是 guest,右边是 host 上的 VMM,最下方是 /dev/kvm。VMM 负责准备 guest kernel、rootfs、CPU、内存和虚拟设备,再通过 /dev/kvm 启动虚拟机。
guest 通过 virtio访问磁盘和网络;请求退出到 host 后,由 VMM 的设备后端处理。KVM 提供内核和硬件虚拟化能力,VMM 把这些能力组织成一台完整虚拟机。
但如果 VMM 为了兼容所有硬件而带着大量设备代码,它自己又会成为新的攻击面。
第 26 页|为什么现代 VMM 更小
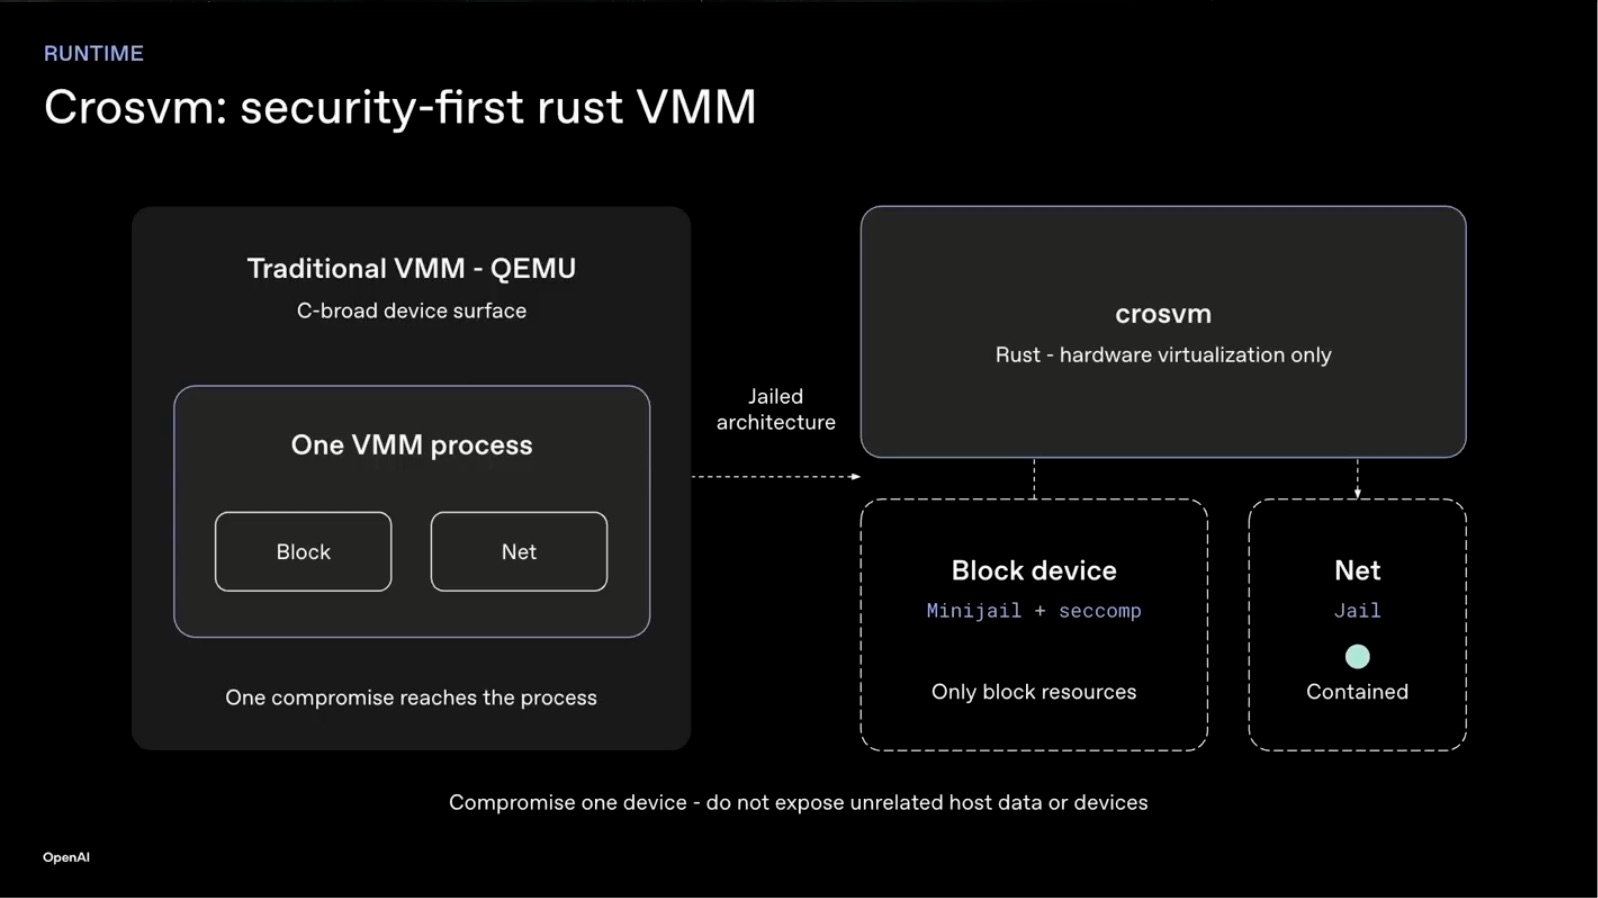
QEMU 支持大量架构和历史设备,功能强,代码面也很大。Crosvm 只保留必要设备,并用 Rust 降低内存安全风险。
块设备和网络设备还可以分别放进 jail。即使一个设备进程被突破,攻击者也拿不到其他设备的全部权限。
VMM 变小、设备变少、启动变快,这几项变化合在一起,就进入了 microVM。
第 27 页|microVM 的 micro
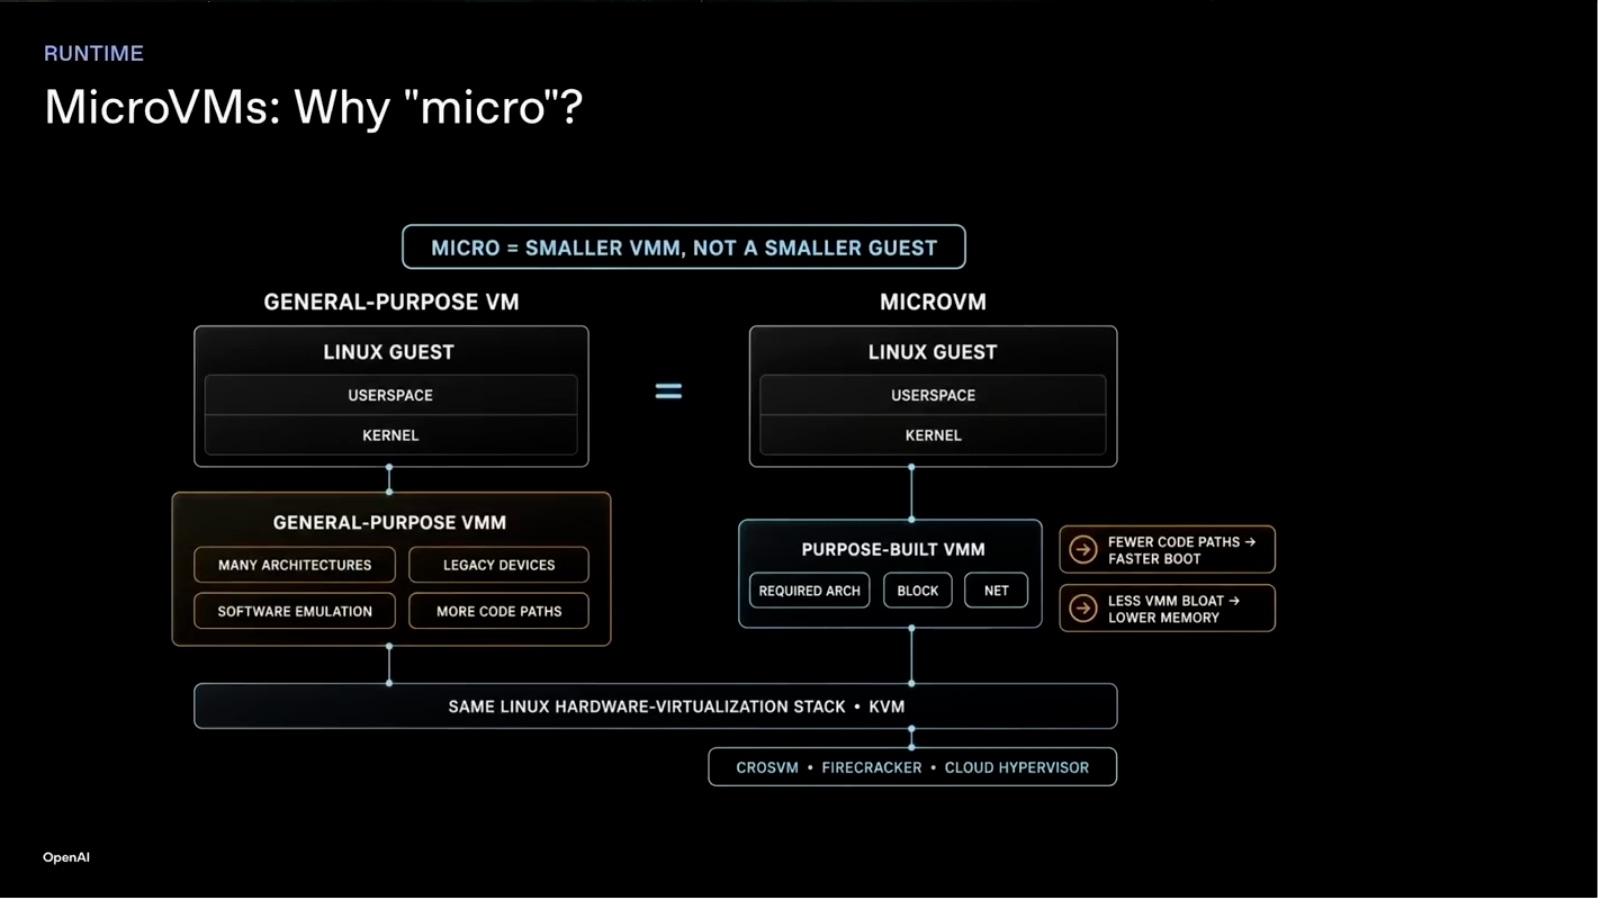
micro 主要指 VMM 更小,不是 guest 里只能运行一个微型系统。
删除不需要的历史设备以后,VMM 内存占用更低、启动更快,同时仍保留虚拟机的硬件隔离。
下一页列出的几种实现,走的都是这条“小 VMM、少设备”的路线。
第 28 页|Crosvm 与其他 Rust VMM
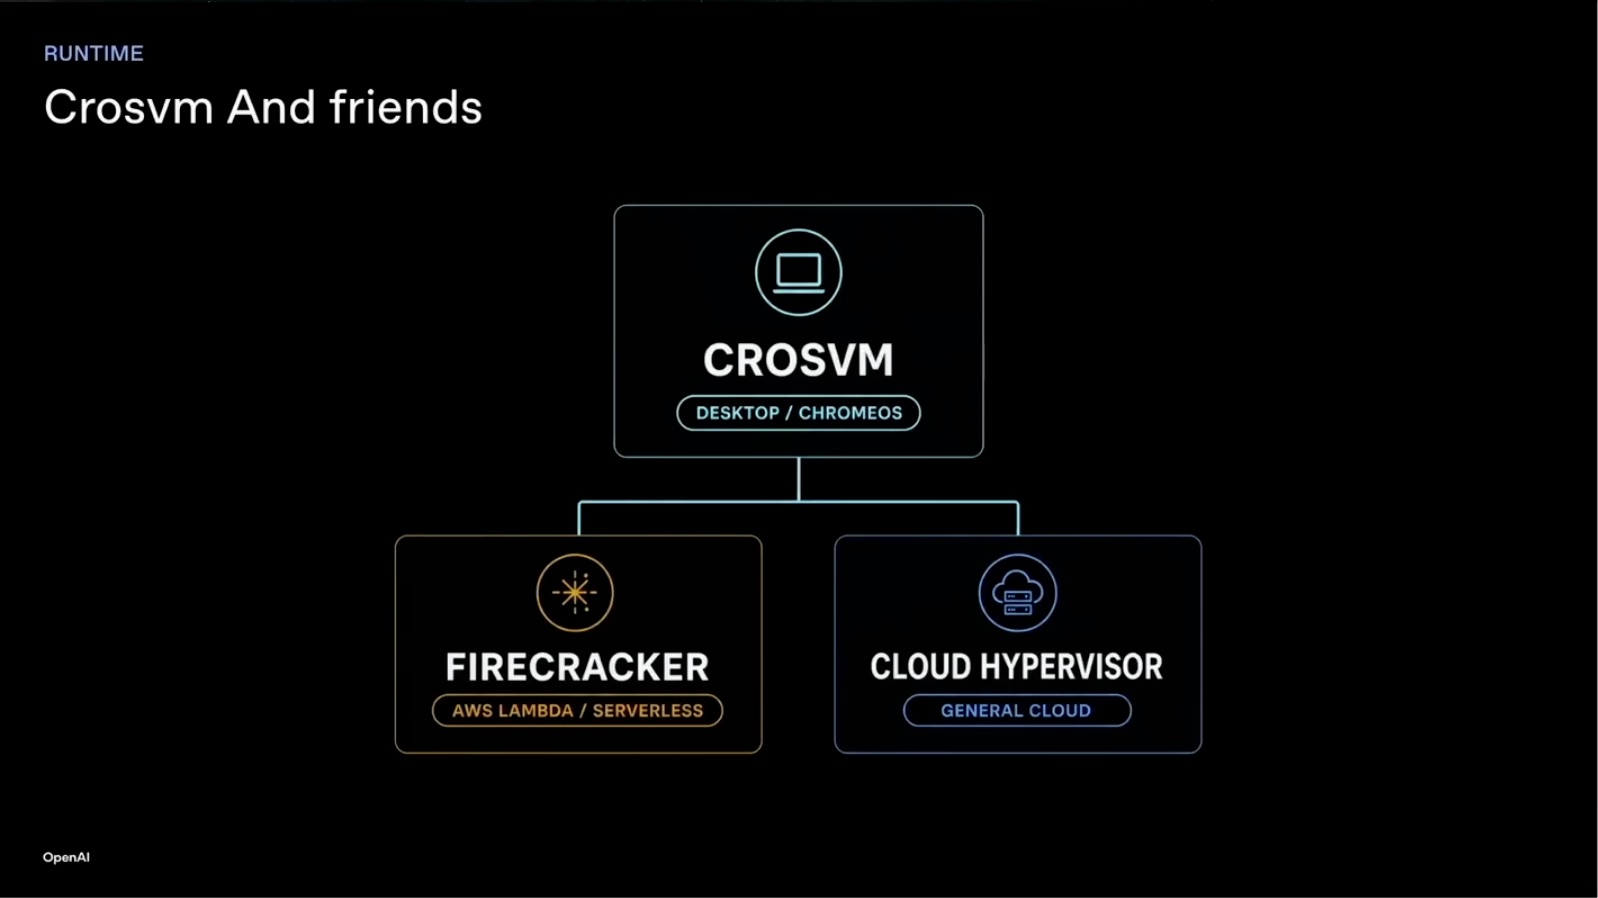
Crosvm、Firecracker和 Cloud Hypervisor 都属于这条技术路线。Crosvm 最早服务桌面和 ChromeOS;Firecracker 用于 AWS Lambda与 serverless。Cloud Hypervisor 面向更通用的云端场景。
这些名字背后的共同方向,是缩小 VMM 和设备攻击面,用内存安全语言实现关键组件。
到这里原理已经够了。接下来回到程序员视角,看 Harness 怎样真正启动一台 microVM。
第 29 页|Harness 怎样启动 microVM
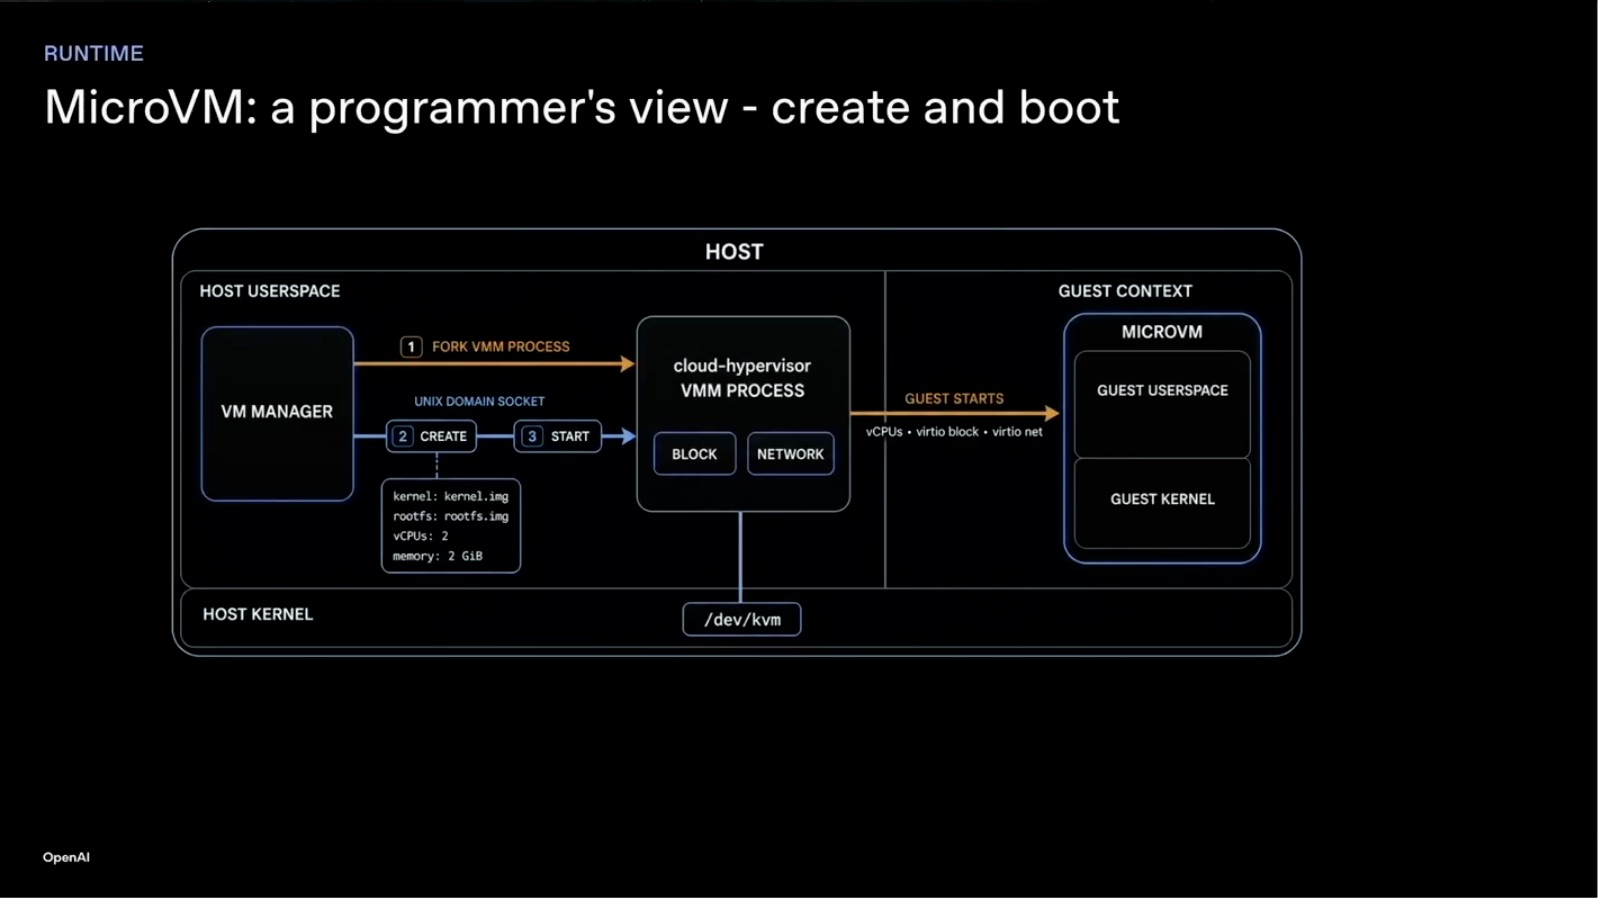
沿图从左往右看:Harness 先通过 VM Manager 启动中间的 Cloud Hypervisor 进程。随后它通过 Unix domain socket 调用 create 和 start API,传入 rootfs、kernel、CPU 与 memory。右边才是被启动的 guest。
VMM 随后调用 /dev/kvm 启动 guest。模型只提出任务,Harness 负责选择和创建执行环境。
这页解决的是“怎样把机器启动起来”。机器运行以后,还需要一条控制 guest 内部动作的通道。
第 30 页|Harness 怎样控制 guest
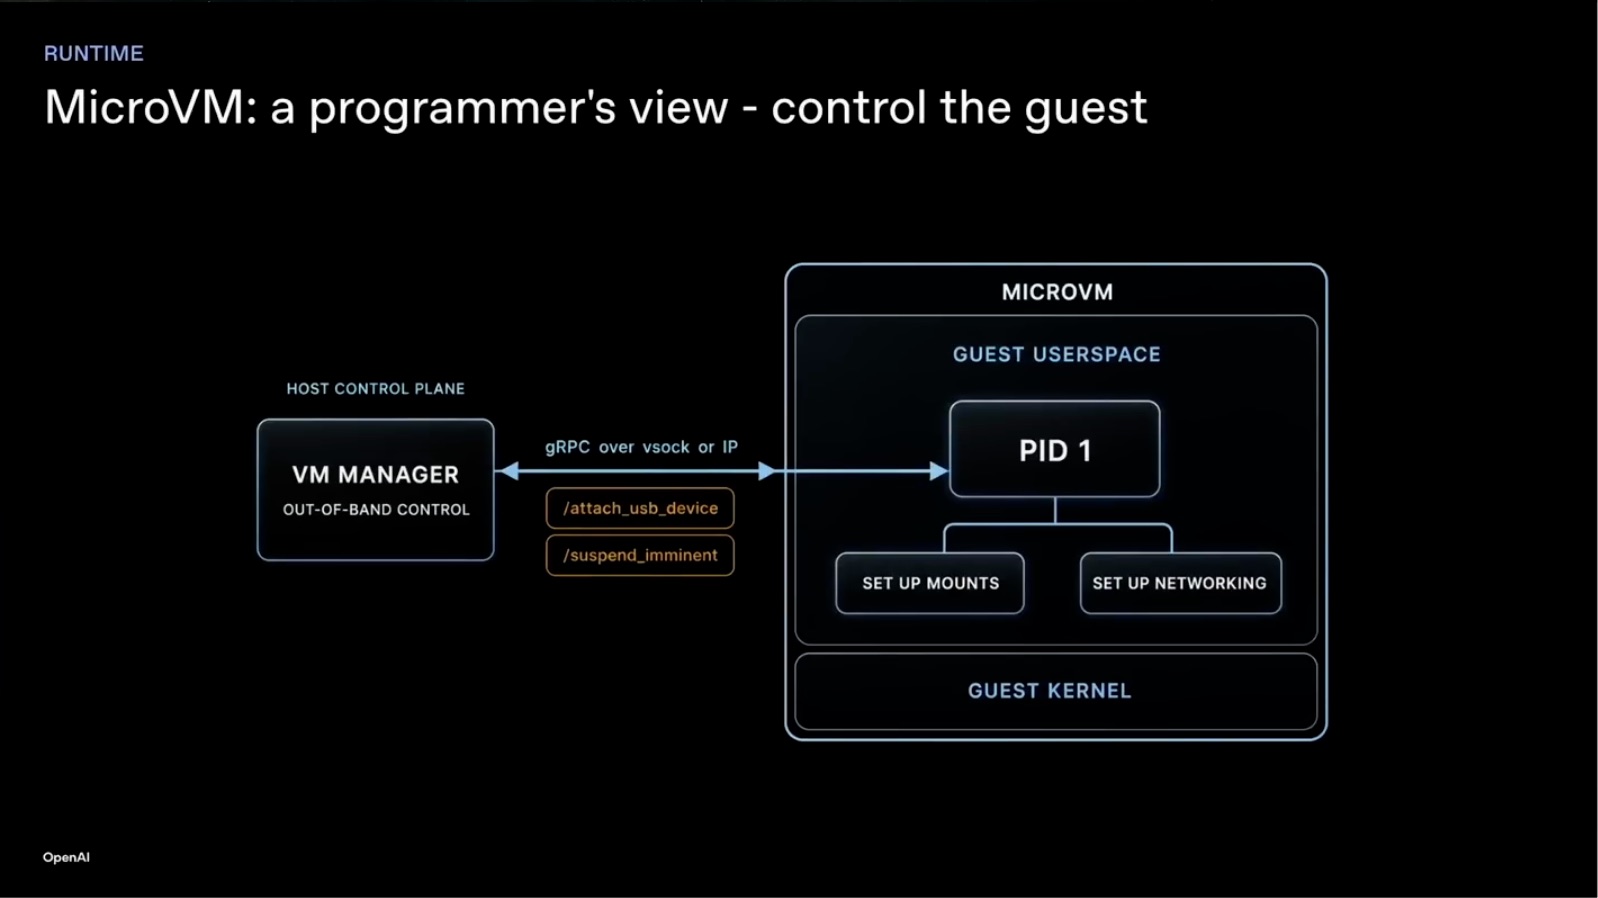
这页的左边仍是 VM Manager,右边是 microVM。虚拟机里有一个作为 PID 1 运行的 Sandbox Server。它负责设置图中的 mounts和 networking,也能接收 attach device 或 suspend等控制请求。
外部 Harness 可以通过 vsock(读作 V-sock,V-索克)或网络访问它。host 侧 API 管虚拟机生命周期,guest 侧 API 管内部执行。
至此,一次工具调用已经被放进了更强的边界。但安全提高以后,系统也要承担新的成本。
第 31 页|microVM 的取舍
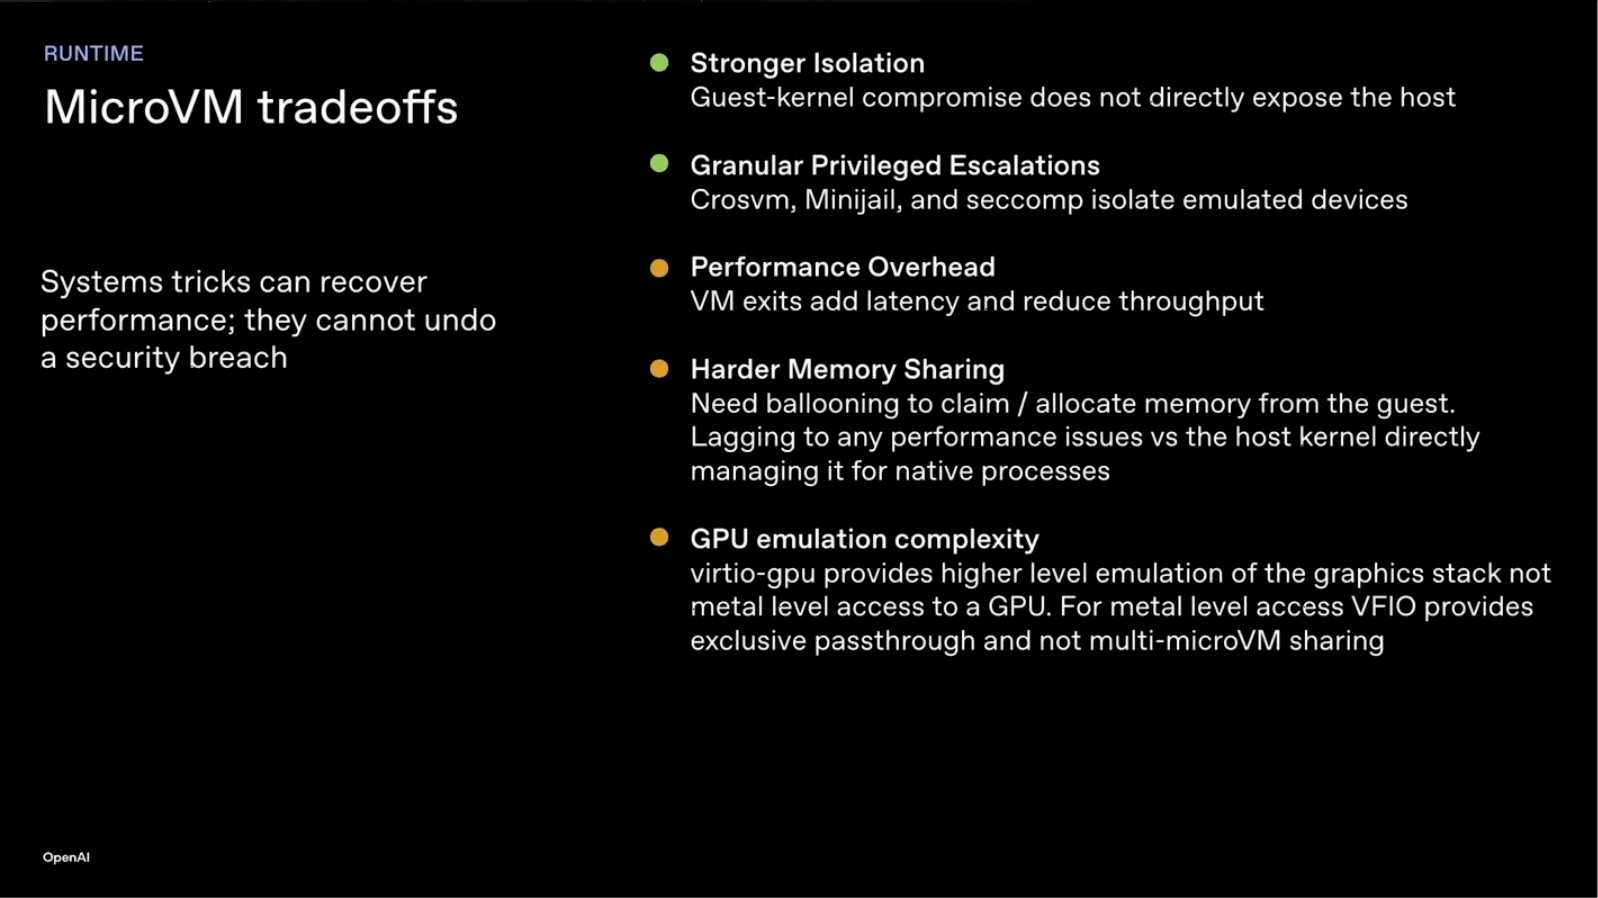
microVM 提供更强的硬件隔离,也带来上下文切换、内存回收和 GPU 共享等成本。内存通常要通过 ballooning请求 guest 归还,不能像普通进程一样立即回收。
GPU 的高层访问可以走 virtio-gpu;如果用 VFIO 直接透传硬件,通常又难以让多个沙箱同时共享。
攻击 host 仍非绝对不可能,但攻击链更长,设备还能继续用 jail 和 seccomp 加固。
Abhishek 的判断是,性能问题可以继续优化,安全事故却很难弥补。因此他建议新团队优先从 microVM 开始。这是他的工程取向,不是所有产品的统一答案。
Runtime 到这里回答了代码怎样运行。接下来,Agent 在这台机器里做过的工作,怎样不随节点一起消失?
第二部分|第 32 页|Persistence
Runtime 解决了代码怎样安全运行。下一步是:Agent 安装的依赖、修改的代码和生成的文件,怎样在节点关闭后继续存在。
这里讨论的是磁盘持久化。
先看没有持久化时,长任务会遇到什么。
第 33 页|为什么需要保存磁盘
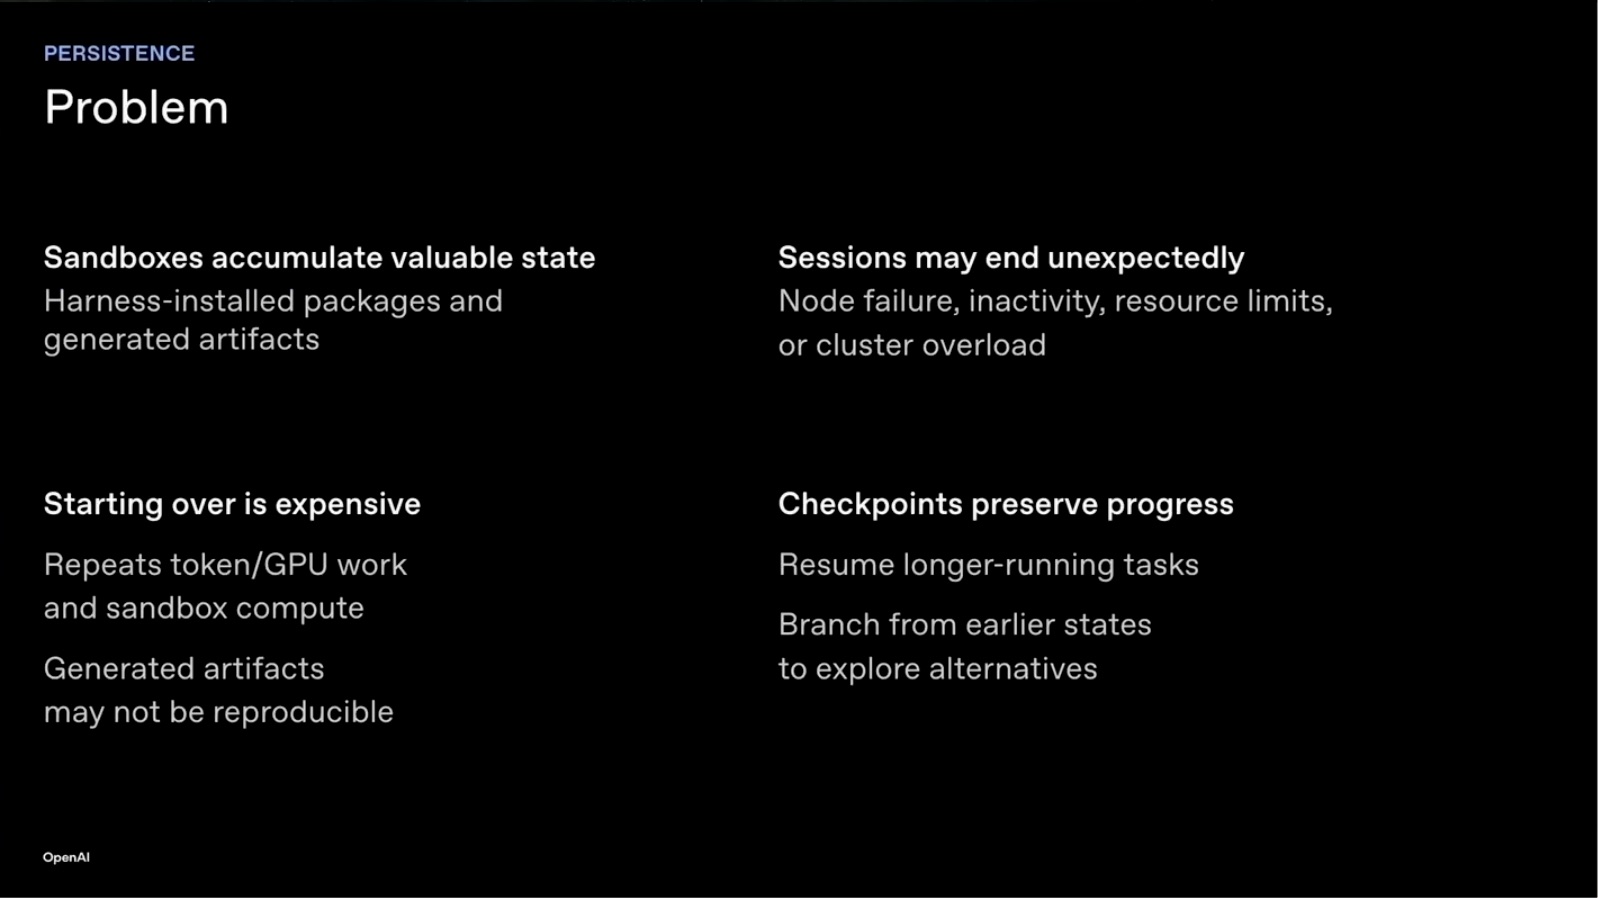
今天的 Agent 会在沙箱里安装依赖,生成完整代码库、演示文稿和其他长任务产物。节点故障、会话结束、资源限制或集群过载,都可能让这段运行突然中止。
如果只能从头开始,平台会重复消耗 GPU token 和 sandbox compute,有些生成结果还未必能够复现。因此保存磁盘状态是可靠性的一部分。
最直接的解决方式,是在任务运行过程中不断留下可以恢复的 checkpoint。
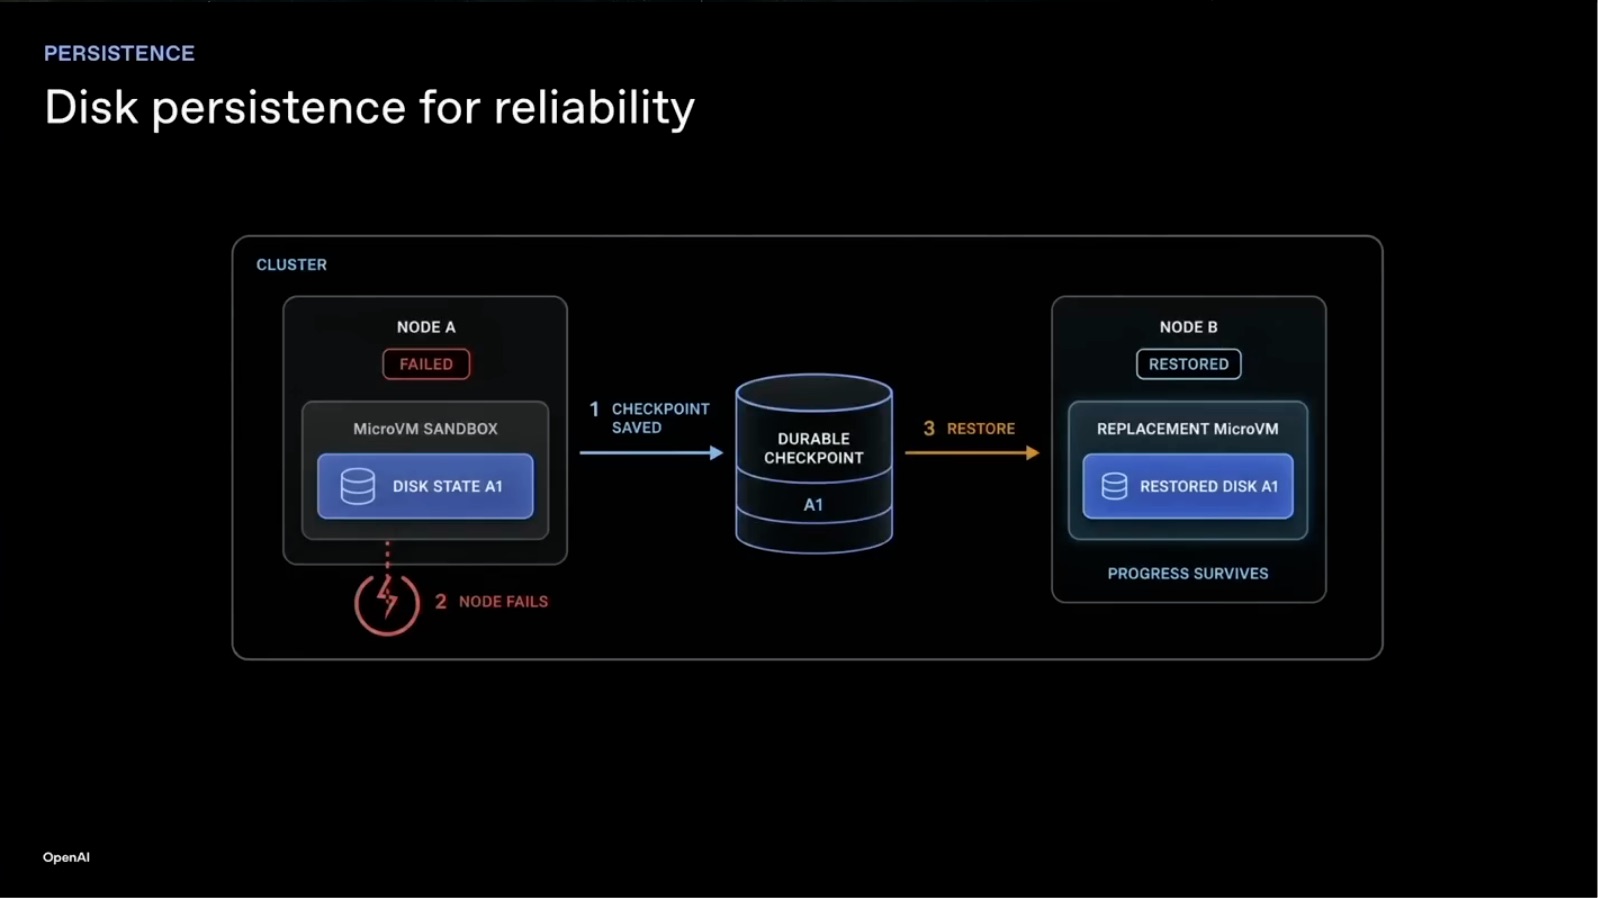
第 34 页|持久化与可靠性
节点失效后,系统可以把 durable checkpoint加载到新节点,让任务从最近状态恢复,不必从零开始。
同一机制也可用于集群升级、节点迁移和 A/B 测试。状态可恢复以后,沙箱才能可靠地跨节点运行。
但 checkpoint 不只用来等故障发生。Harness 还可以主动利用它探索不同方案。
第 35 页|快照改变 Harness 的能力
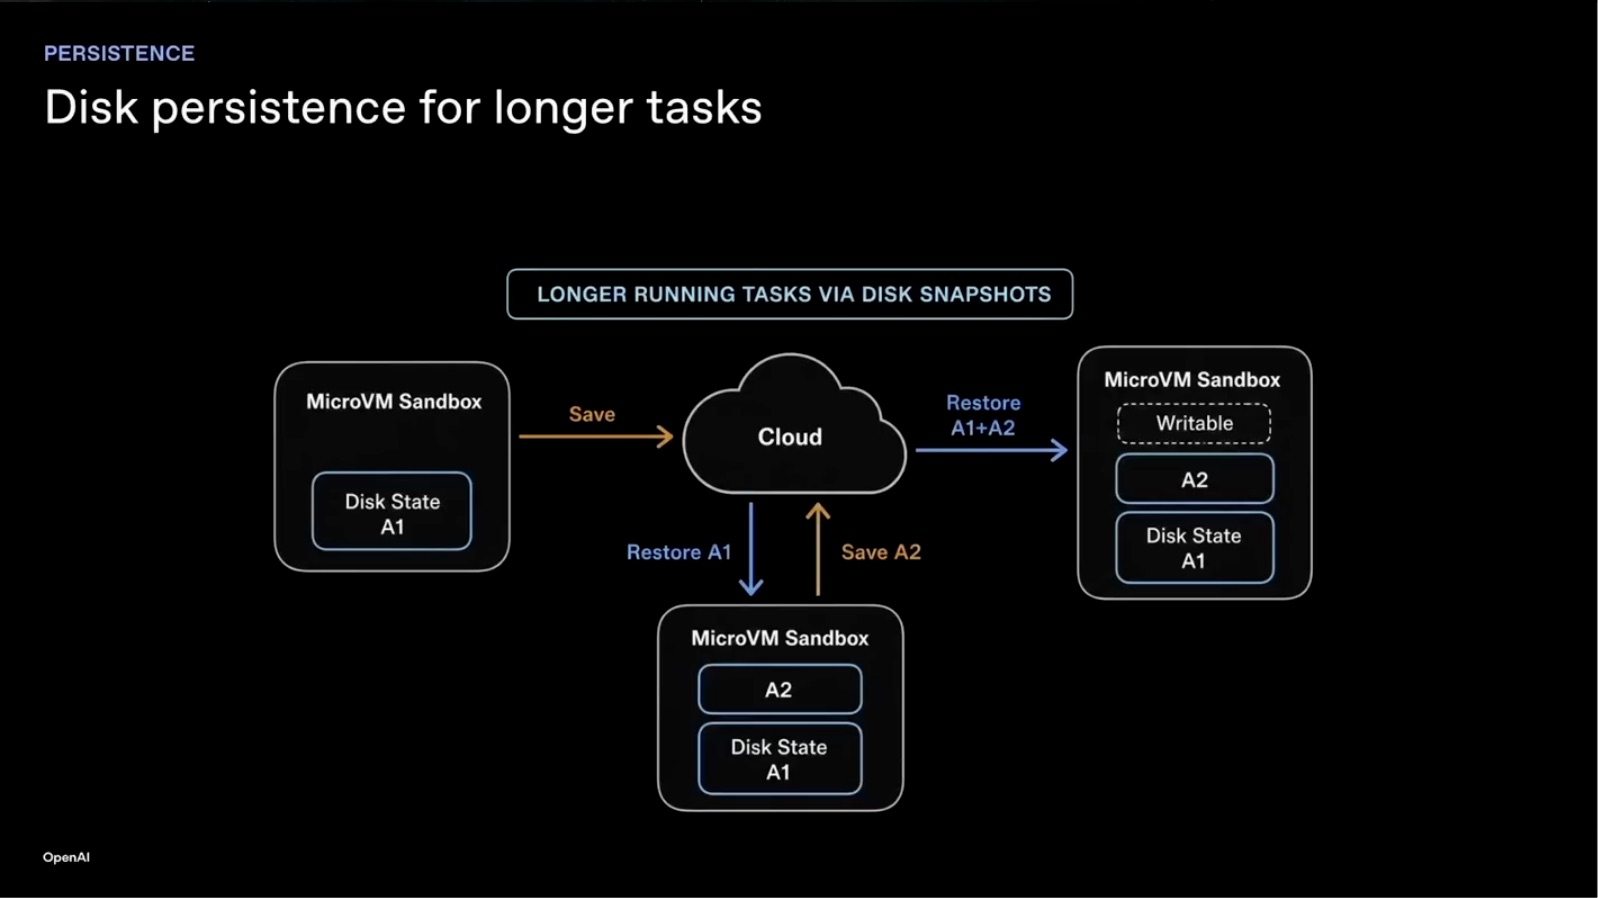
沿图的箭头看:左上的 microVM 先保存磁盘状态 A1,A1 经过中间的云端存储,恢复到左下另一只 microVM,再继续产生 A2。最后看右边,下一次恢复时,A1 和 A2 会一起还原,任务不用从头开始。
同一套 checkpoint 也允许 Harness 从某个中间状态分支、失败后回退,再尝试其他路径。这样 rollout 可以形成跨多天的搜索过程。这里保存的是沙箱里的软件和文件状态,不是模型权重。
要让 Harness 频繁保存和回退,Snapshot API 本身就不能又慢又贵。
第 36 页|快照系统的目标
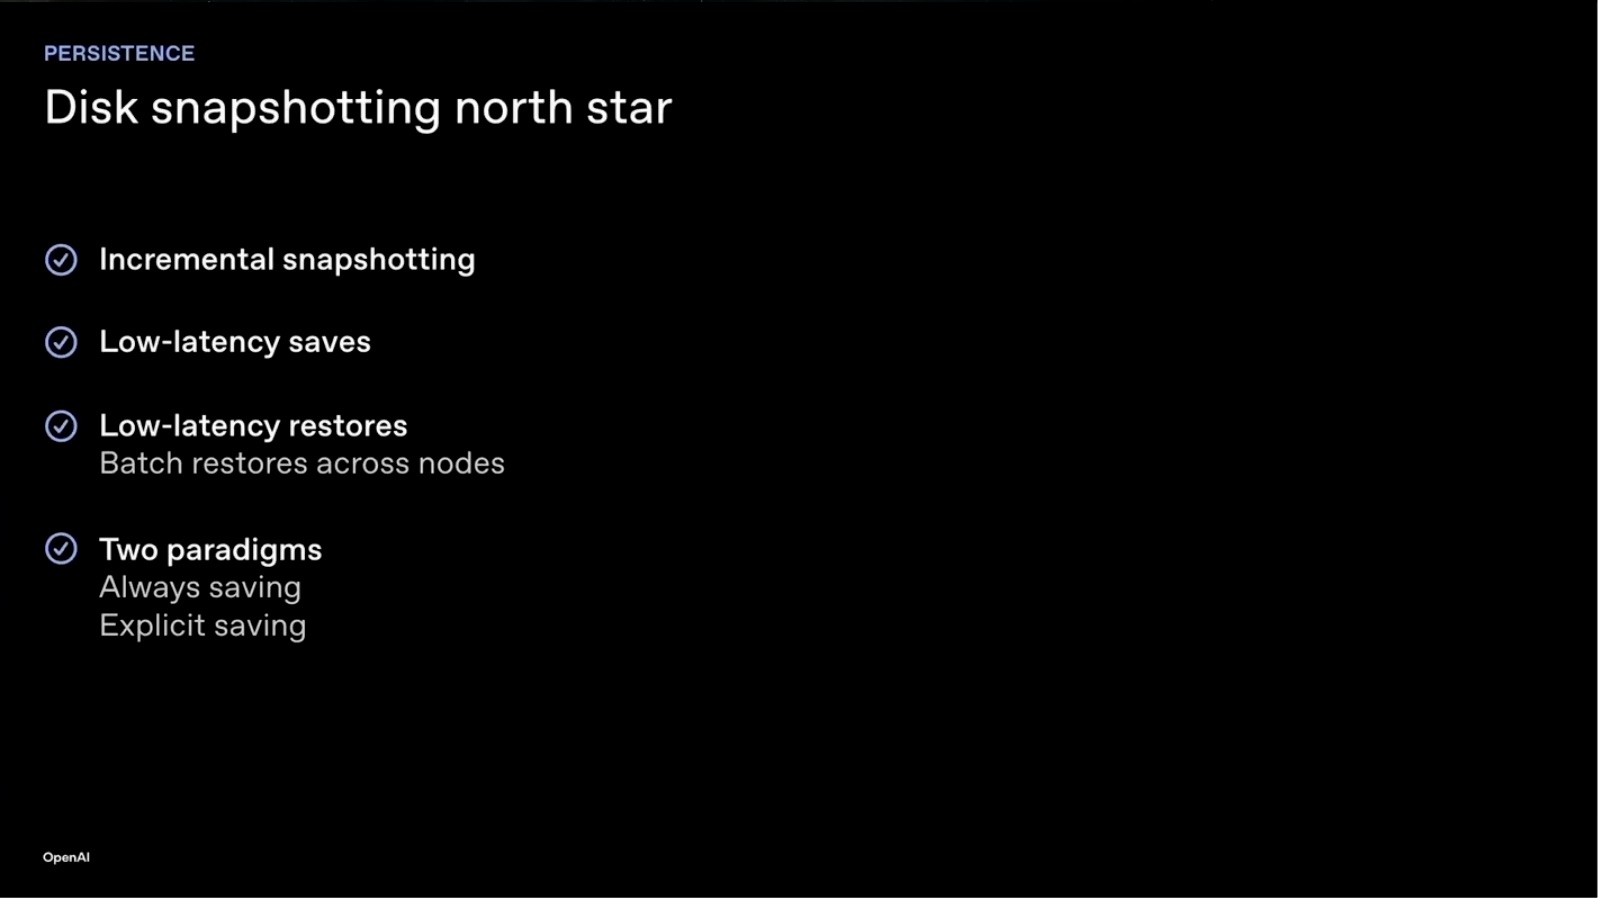
在 ChatGPT 或 Codex 的规模上,快照应该只保存上一次以后发生的变化,而不是每次复制完整磁盘。
Save 和 Restore 都要足够快,恢复还要支持跨节点批量进行。系统可以选择持续写入的 always-on persistence,或者由 Harness 主动调用的 explicit save。
这些目标确定以后,下一步才是选择快照究竟保存什么、以多细的粒度保存。
第 37 页|磁盘快照的设计选择
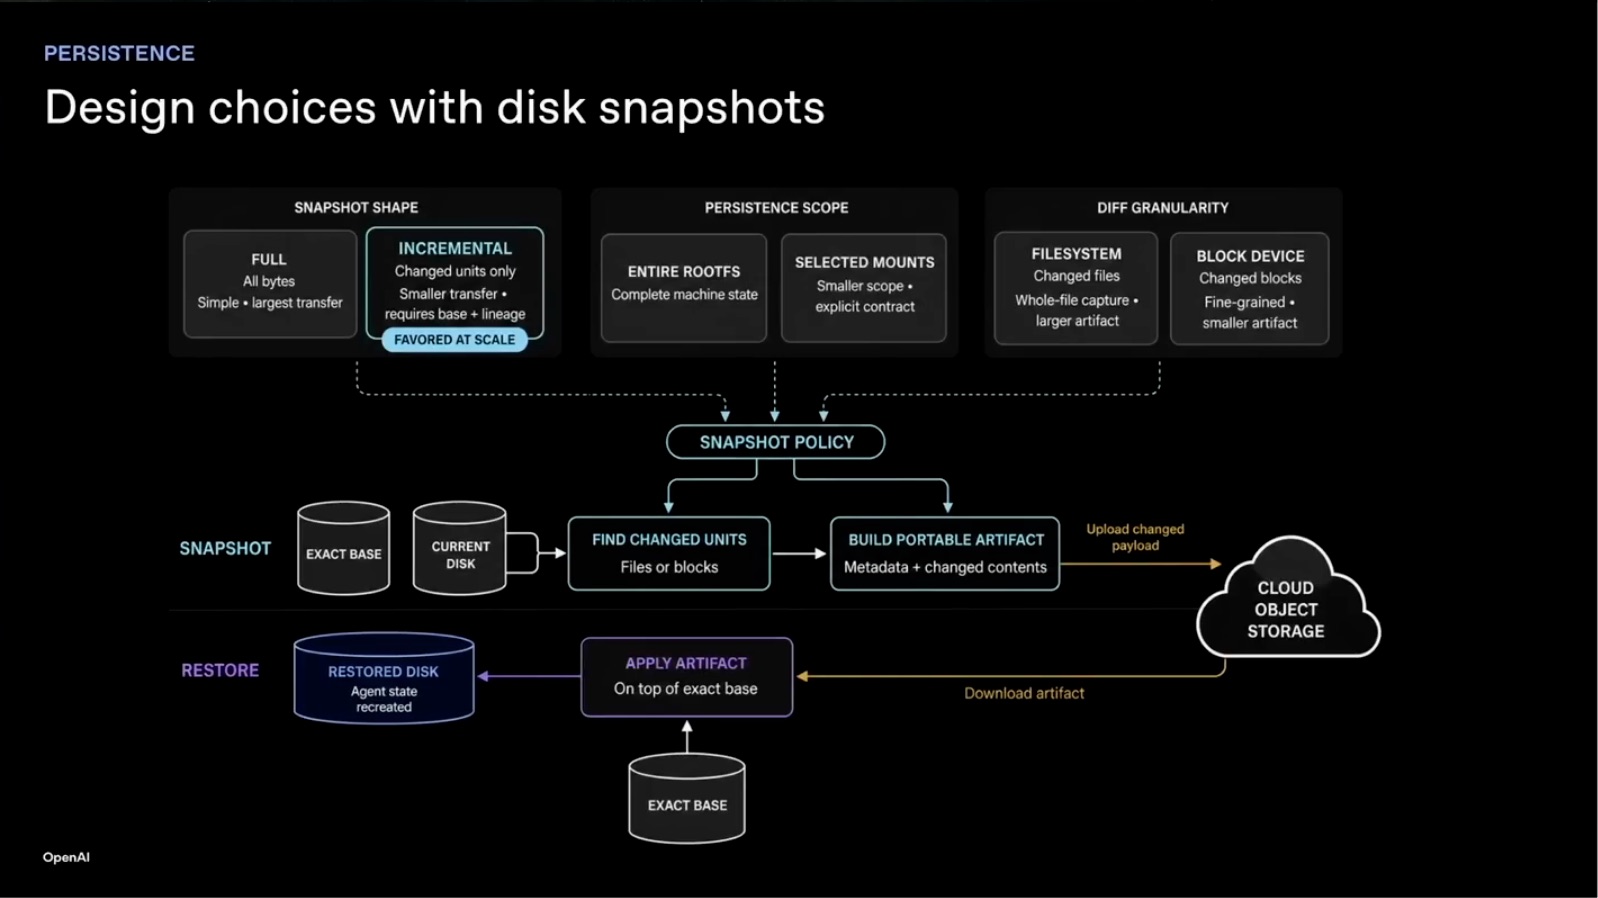
这页分上下两部分。上面是三组设计选择:全量还是增量;保存整个 rootfs 还是指定目录;在文件层还是块设备层追踪变化。
再看下面的流程:系统从左边的 base 和当前磁盘找出变化,生成可携带的 artifact并上传对象存储。恢复时则沿反向路径,把同一 artifact 应用到完全匹配的 base 上。
块级方案只保存真正改变的范围,更适合大规模增量快照。
要理解“变化的块”是怎么找到的,Abhishek 又退回 Linux 存储的第一层。
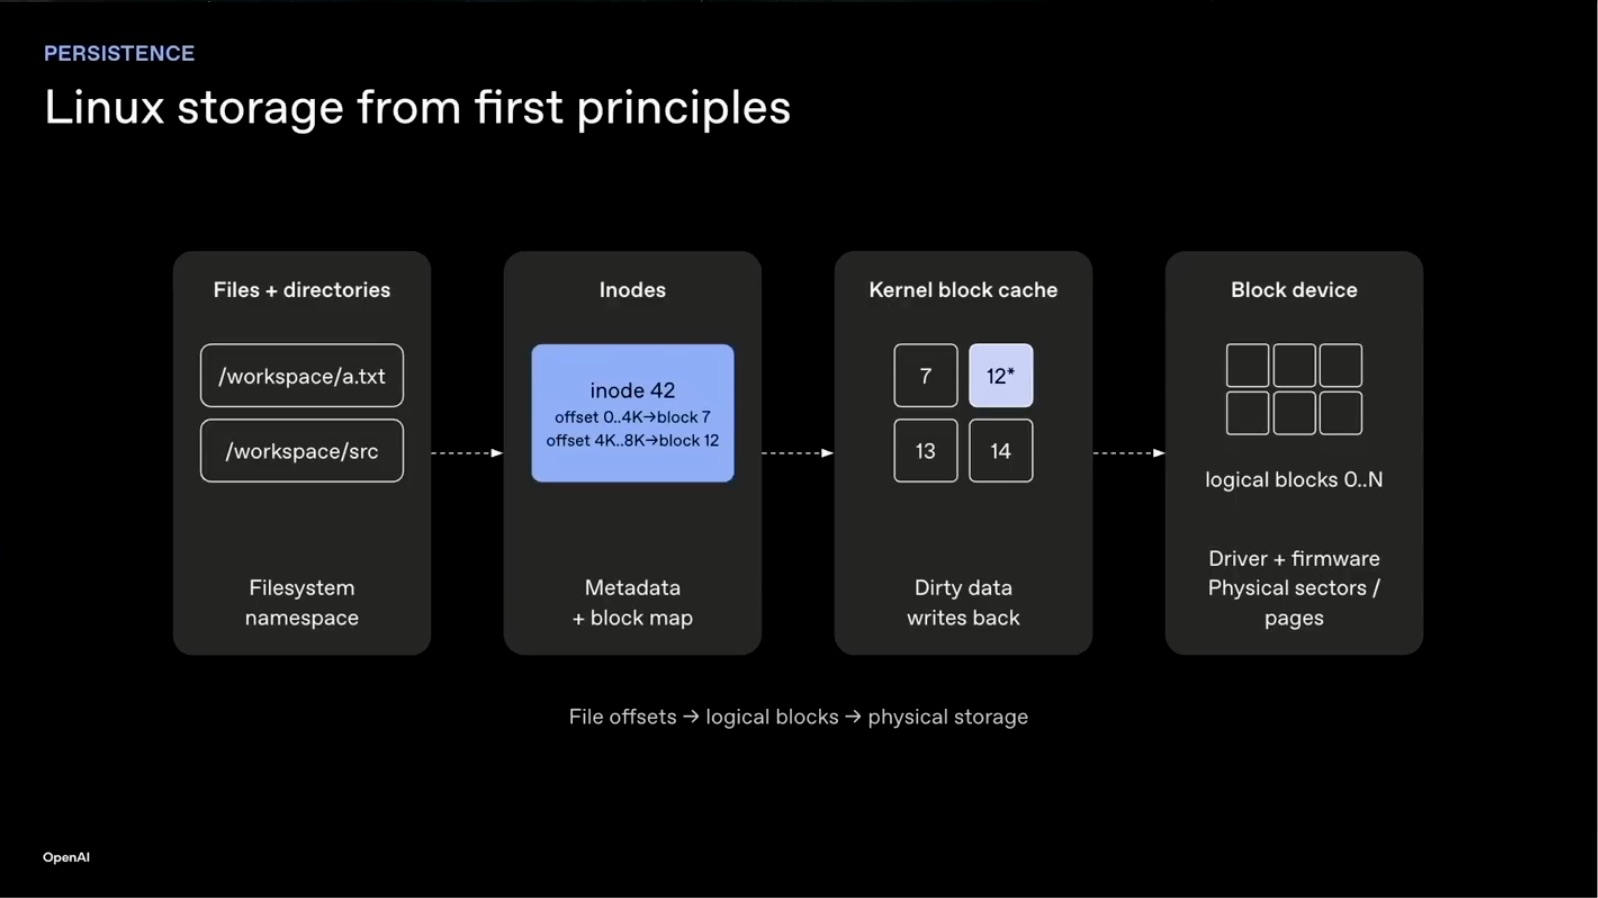
第 38 页|Linux 文件怎样落到块上
Linux 把磁盘表示成一系列逻辑块。文件通过 inode、文件系统和页缓存落到这些块上,inode 等结构记录了它们之间的对应关系。
知道两次快照之间哪些块发生变化,系统就不必重新上传整块磁盘。
有了文件到块的映射,接下来要决定 microVM 是按文件访问 host,还是把存储当成一块磁盘。
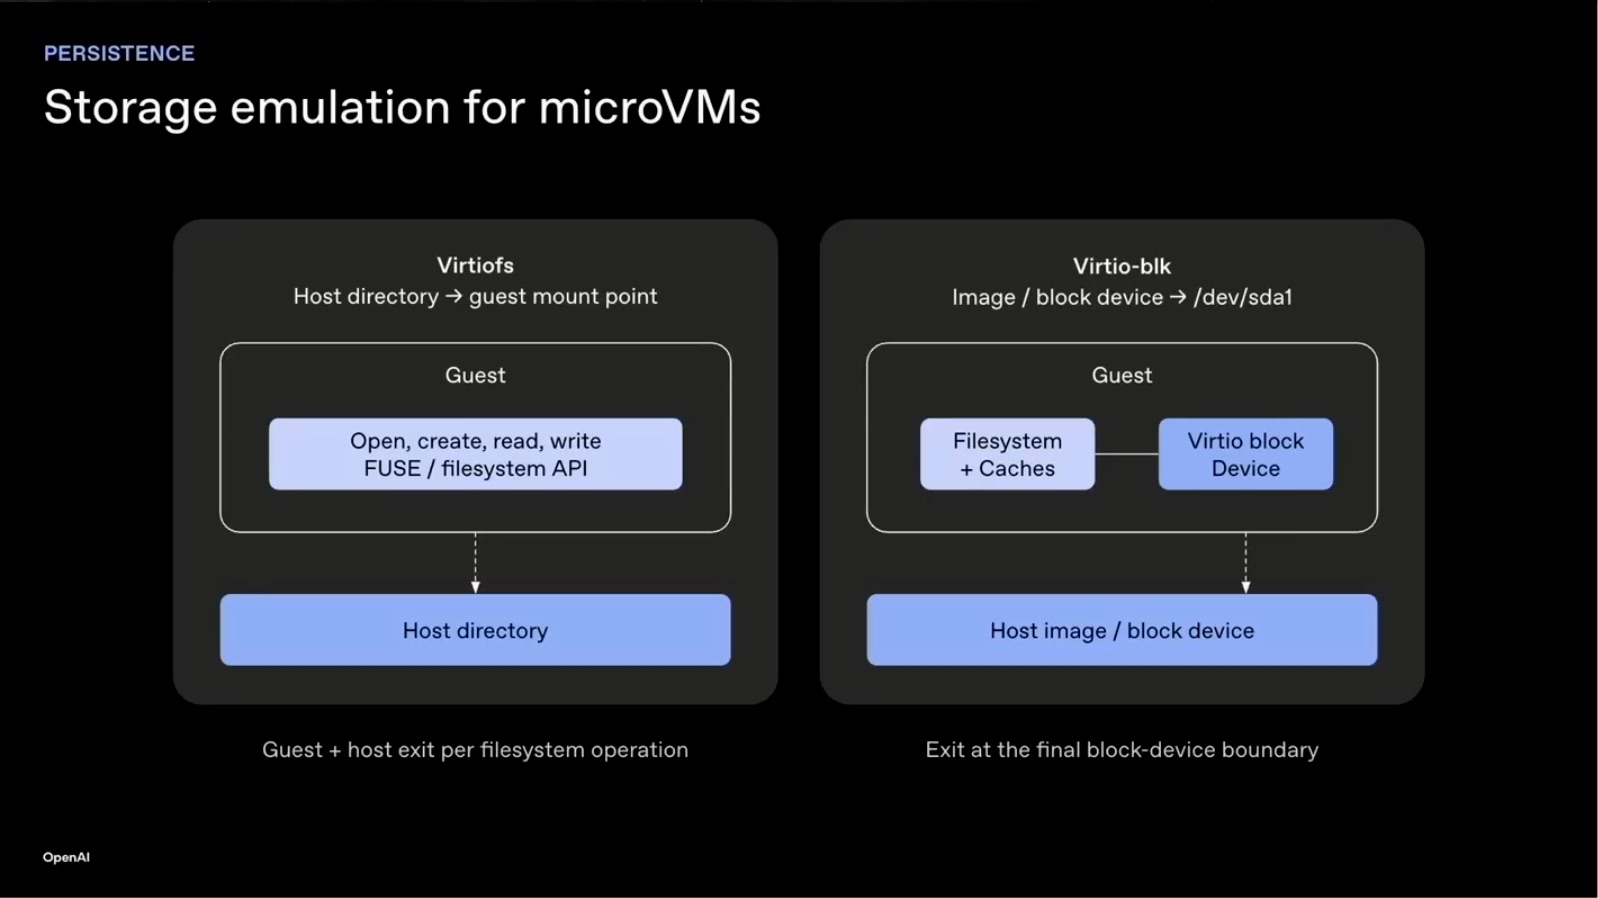
第 39 页|共享文件夹还是块设备
文件级共享 virtiofs 很直观,但 guest 的大量文件操作都可能退出到 host 处理。
virtio-blk 则向 microVM 提供块设备。guest 可以使用自己的文件系统和缓存,只有真正读写磁盘块时才跨越边界,通常更高效。
后面的两套持久化方案都会建立在块设备上:一套由 Harness 明确调用 Save,另一套让每次写入持续落向云端。
第 40 页|显式 Save API
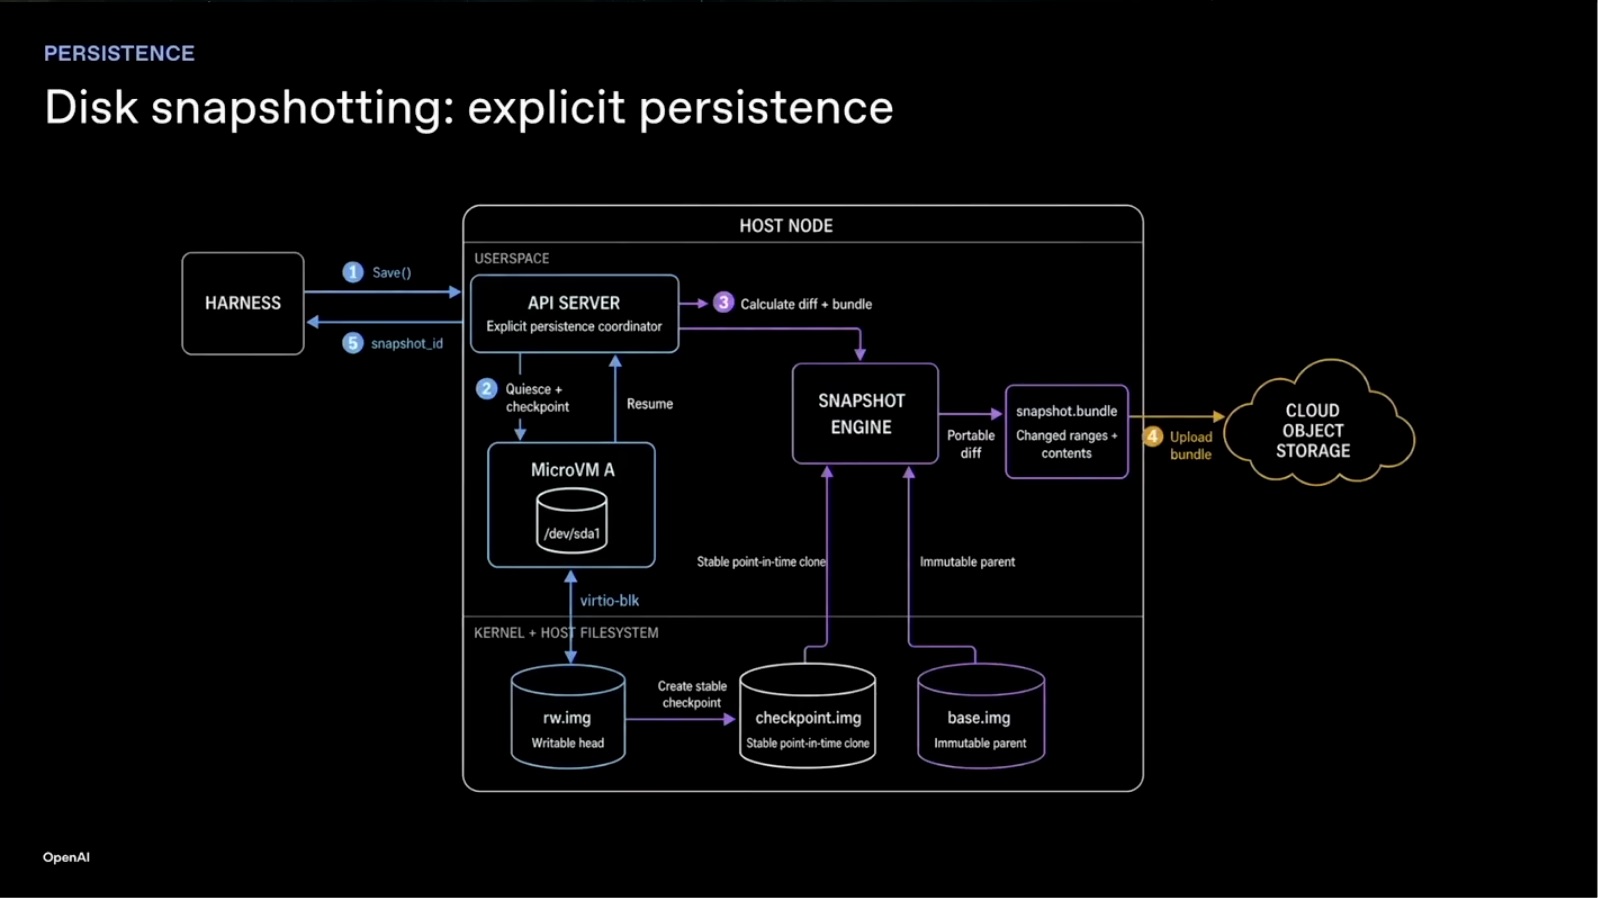
按图中 1 到 5 的编号走:左边 Harness 调用 Save API;中间的系统先让 microVM 暂停写入,建立一个时间点一致的 checkpoint,然后尽快恢复任务。
Snapshot Engine 再计算差异、生成 artifact,并开始上传到右边的对象存储。系统可以先向 Harness 返回 snapshot ID,让上传在后台继续。
恢复时,系统根据 ID 找到从基础镜像到当前状态的所有差异层,再按顺序应用。
这张图说明 Save API 的控制流程;下一页继续进入块级 diff 在节点上怎样实现。
第 41 页|CoW 与 FIEMAP
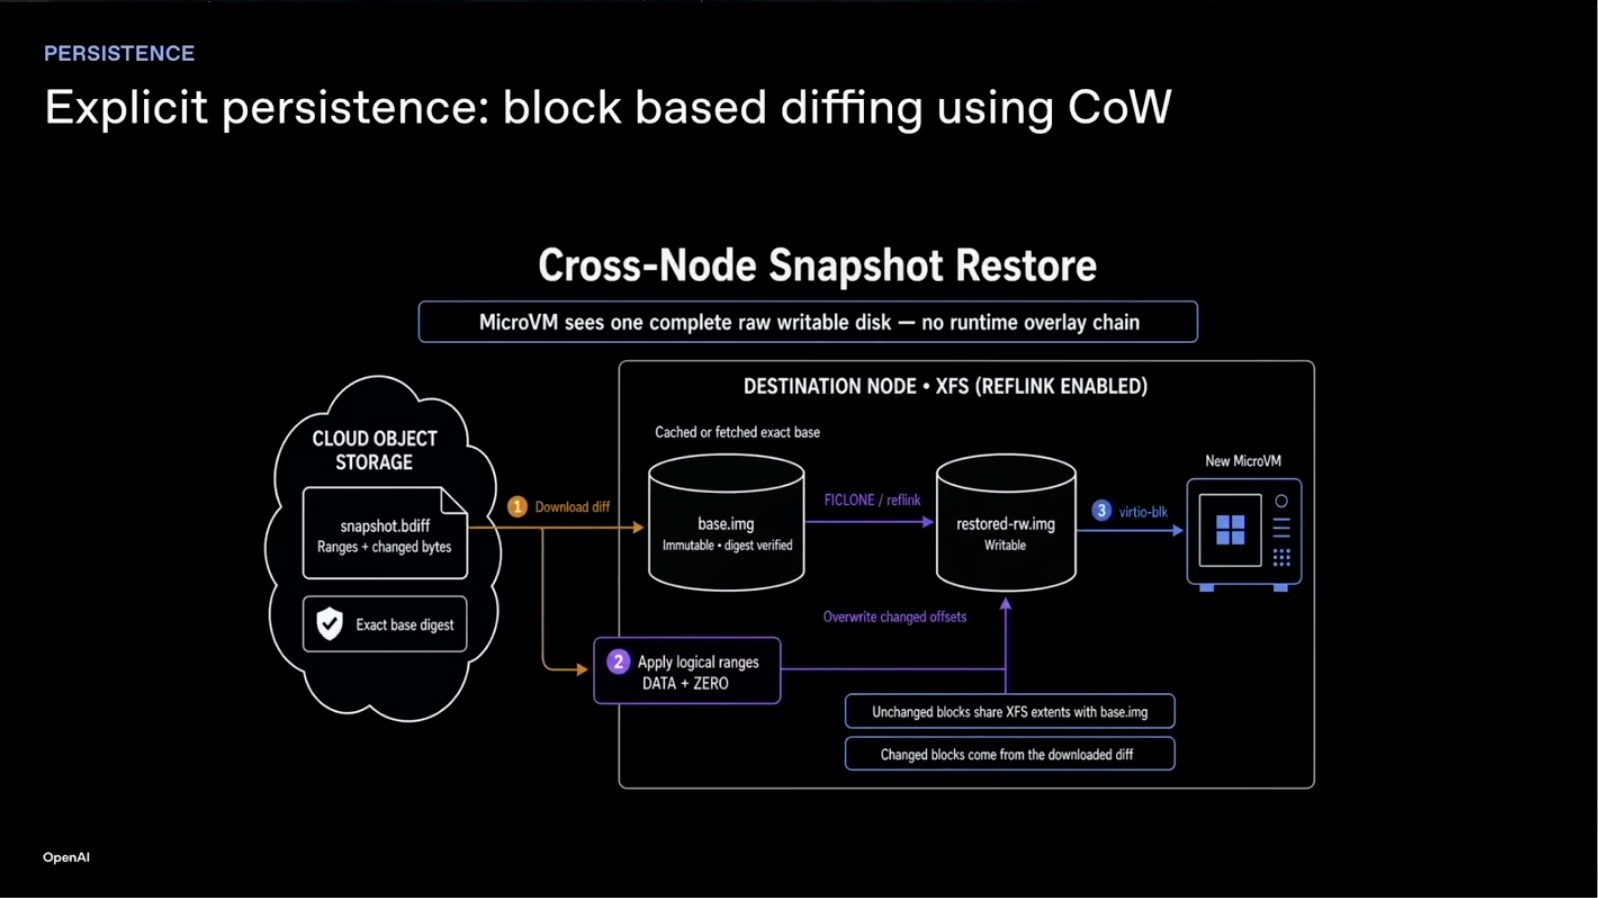
Copy-on-Write 让 base 和差异层组成一个 writable image,再提供给 microVM。只有真正修改的数据块才会产生新内容。
FIEMAP 找出发生变化的连续块范围,系统只上传这些差异。这就是上一页为什么可以先返回 snapshot ID:Save 不必等到后台上传全部完成,才把控制权交还给 Harness。
跨节点恢复时,目标节点先确认 exact base,再用 reflink 生成新的 writable image,把变化范围覆盖进去。未修改的数据块继续与 base 共享,修改过的块来自下载的 diff。
显式保存需要 Harness 选择保存时机。另一种思路,是让持久化始终在线。
第 42 页|Always-on Persistence
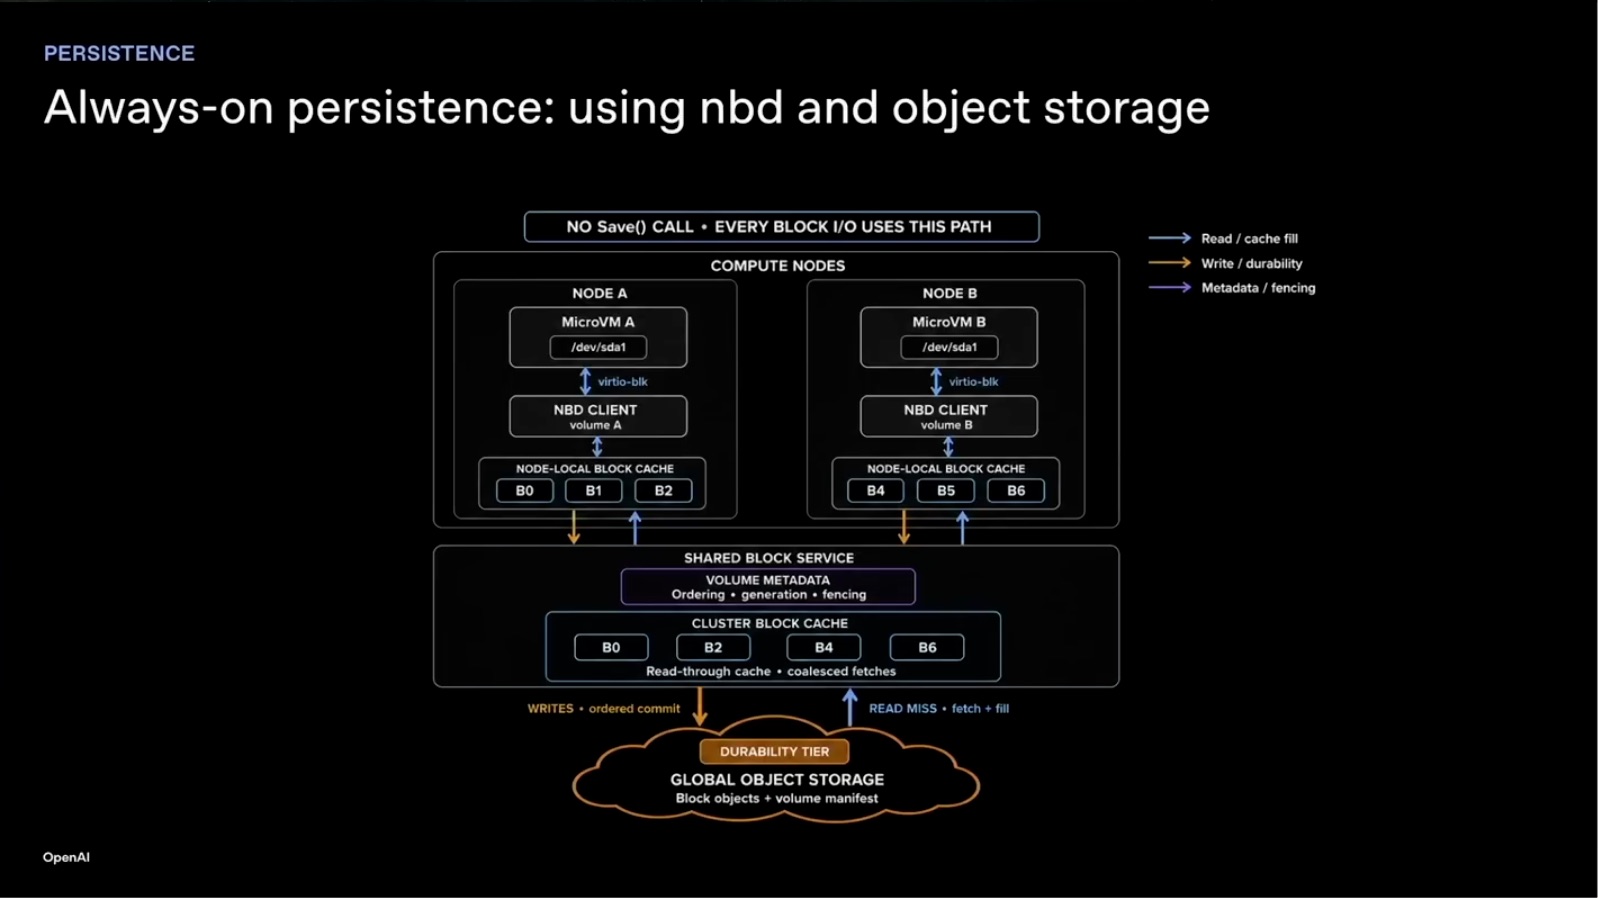
这张图从上往下分三层。最上面是多个 compute node,microVM 通过 NBD client 读写块设备;中间是节点本地缓存、共享块服务和集群缓存;最下面是对象存储。
请求沿着这条路径逐层下沉,不需要 Harness 显式调用 Save。
共享服务还要维护 volume metadata、写入顺序和 fencing,避免不同节点同时写坏状态。这是一种参考设计,不代表 OpenAI 唯一的线上实现。
Abhishek 在这一部分最想留下的判断是:compute 只是第一次 unlock,storage 会是下一次。只有状态能快速保存和恢复,Harness 才能从故障中继续,也才能分支、回退,探索更长时间。
现在,沙箱既能安全运行,也能跨节点恢复。最后还要解决:全球那么多请求,具体应该落到哪里?
第三部分|第 43 页|Orchestration
单个节点终究会故障,也无法服务全球用户。
第三部分讨论怎样把支持 microVM 的机器组成 cluster,再把 cluster 分布到不同 region。
先看整个调度层级。
第 44 页|从区域到节点
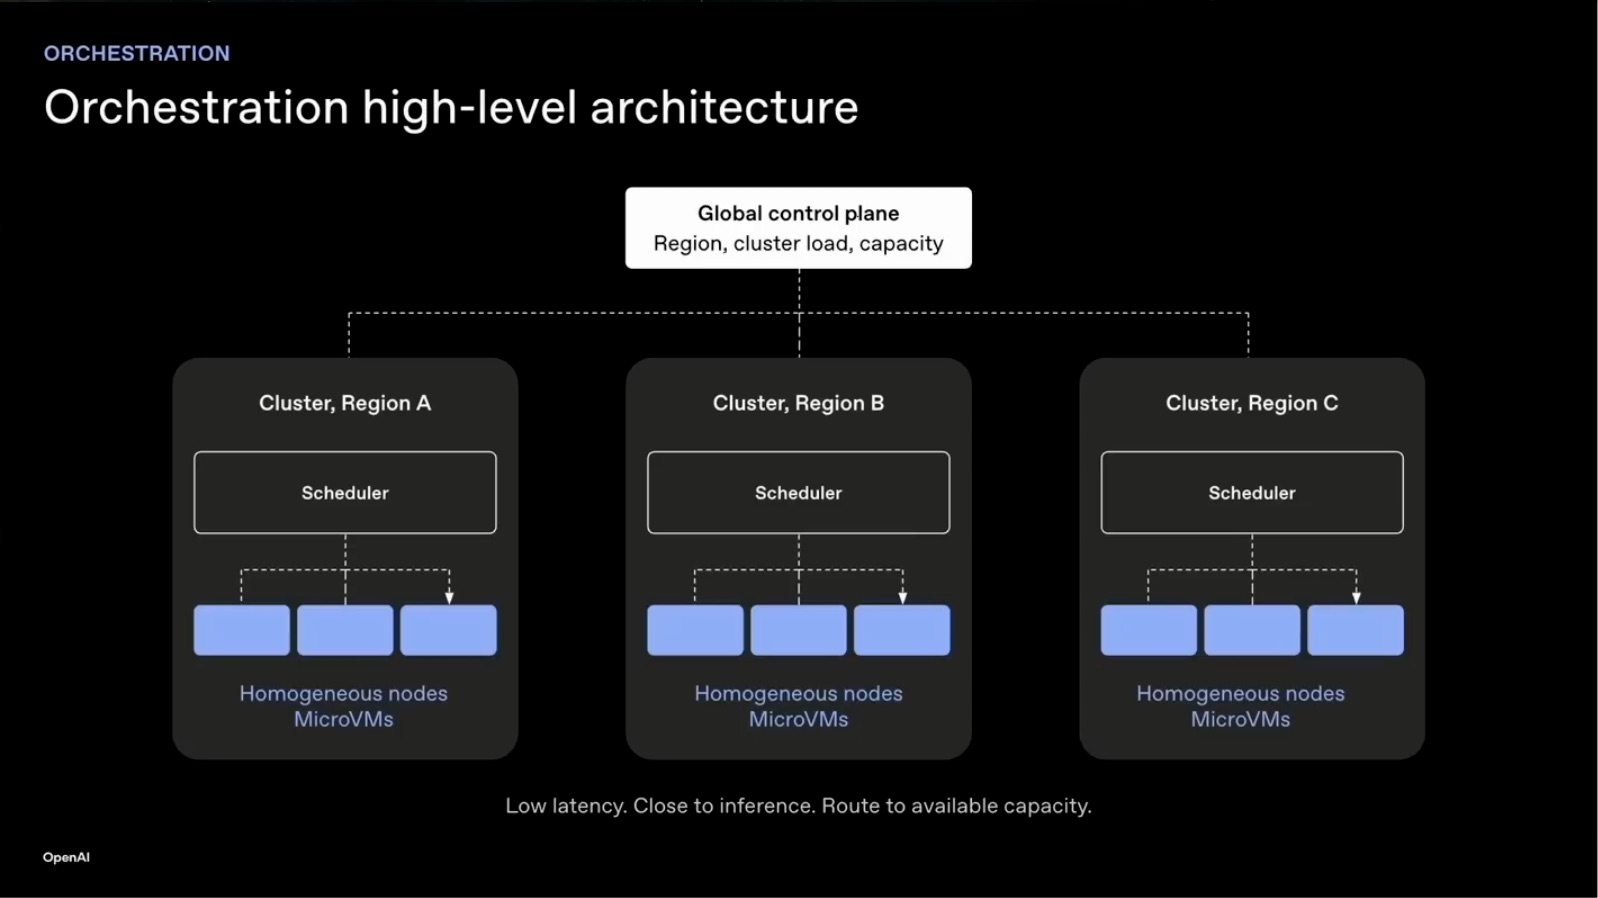
这张图从上往下是三层调度。顶层 control plane 根据区域、负载和容量选择 cluster;中间是分布在不同 region 的 Sandbox Cluster。
进入 cluster 以后,scheduler再根据负载和节点状态选择具体机器。
理想情况下,Sandbox Cluster 还要靠近模型和 Harness 所在的集群,减少通信延迟。
节点选对了还不够。如果每次都从冷状态启动 microVM,用户仍然会等待。
第 45 页|怎样降低启动延迟
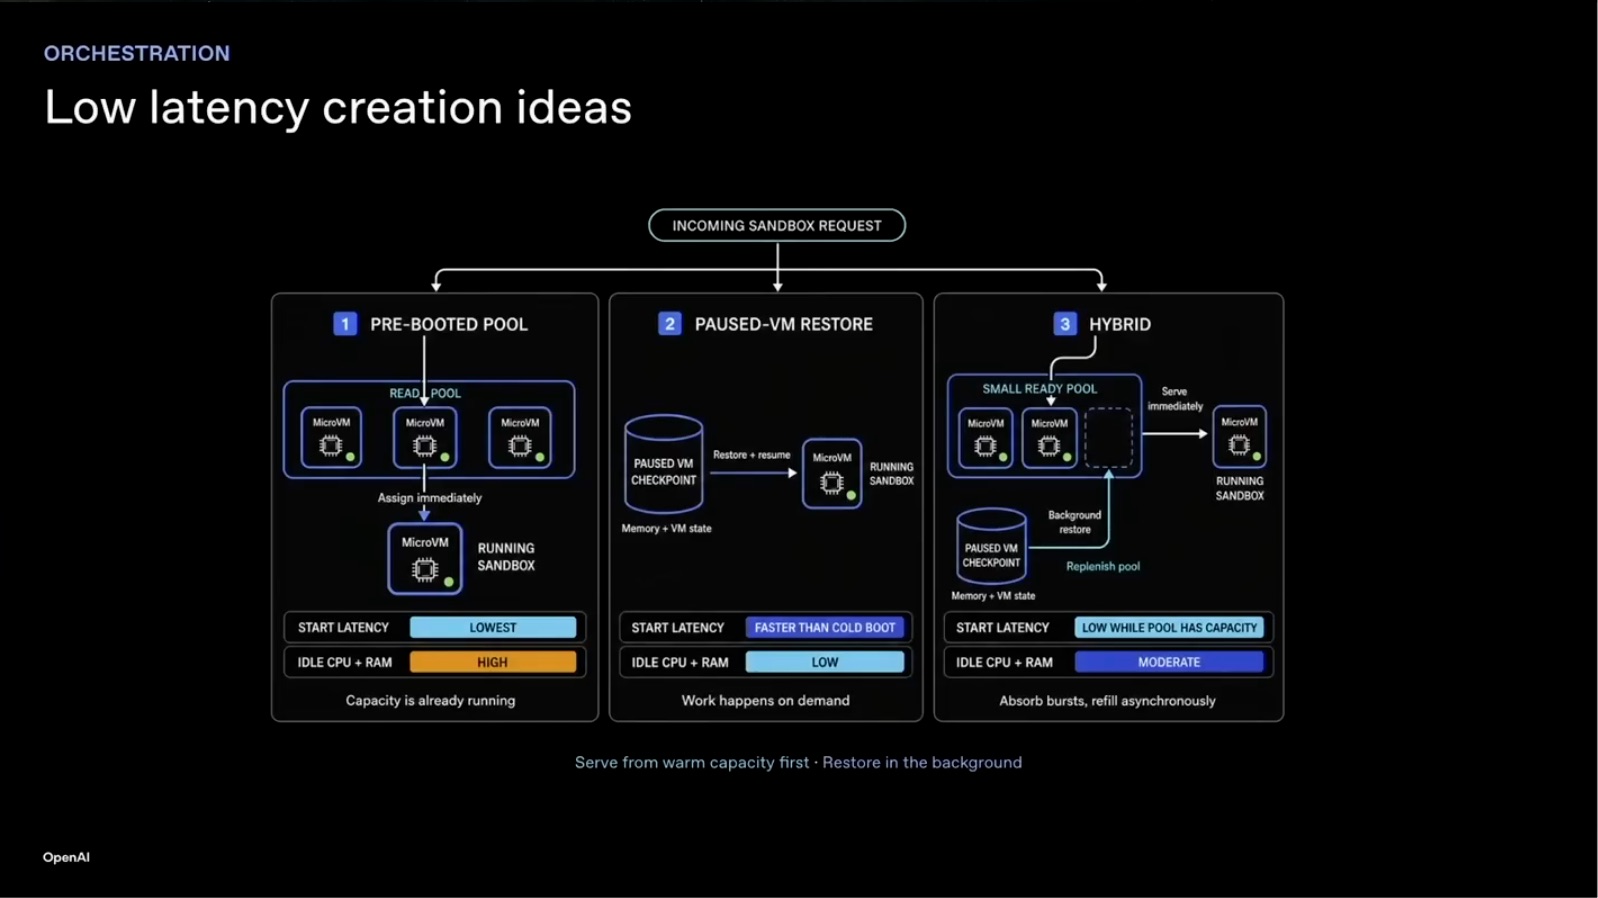
第一种是预启动一池 microVM,请求到来时直接分配,启动延迟最低,但空闲 CPU 和内存成本最高。
第二种是从暂停的 VM 内存快照按需恢复,空闲成本低,但仍有恢复时间。第三种是混合方案:保留一个小型 ready pool 立即响应,再在后台用快照补充容量。
这里的内存快照主要解决冷启动;前面的磁盘快照主要保存 Agent 已完成的工作。
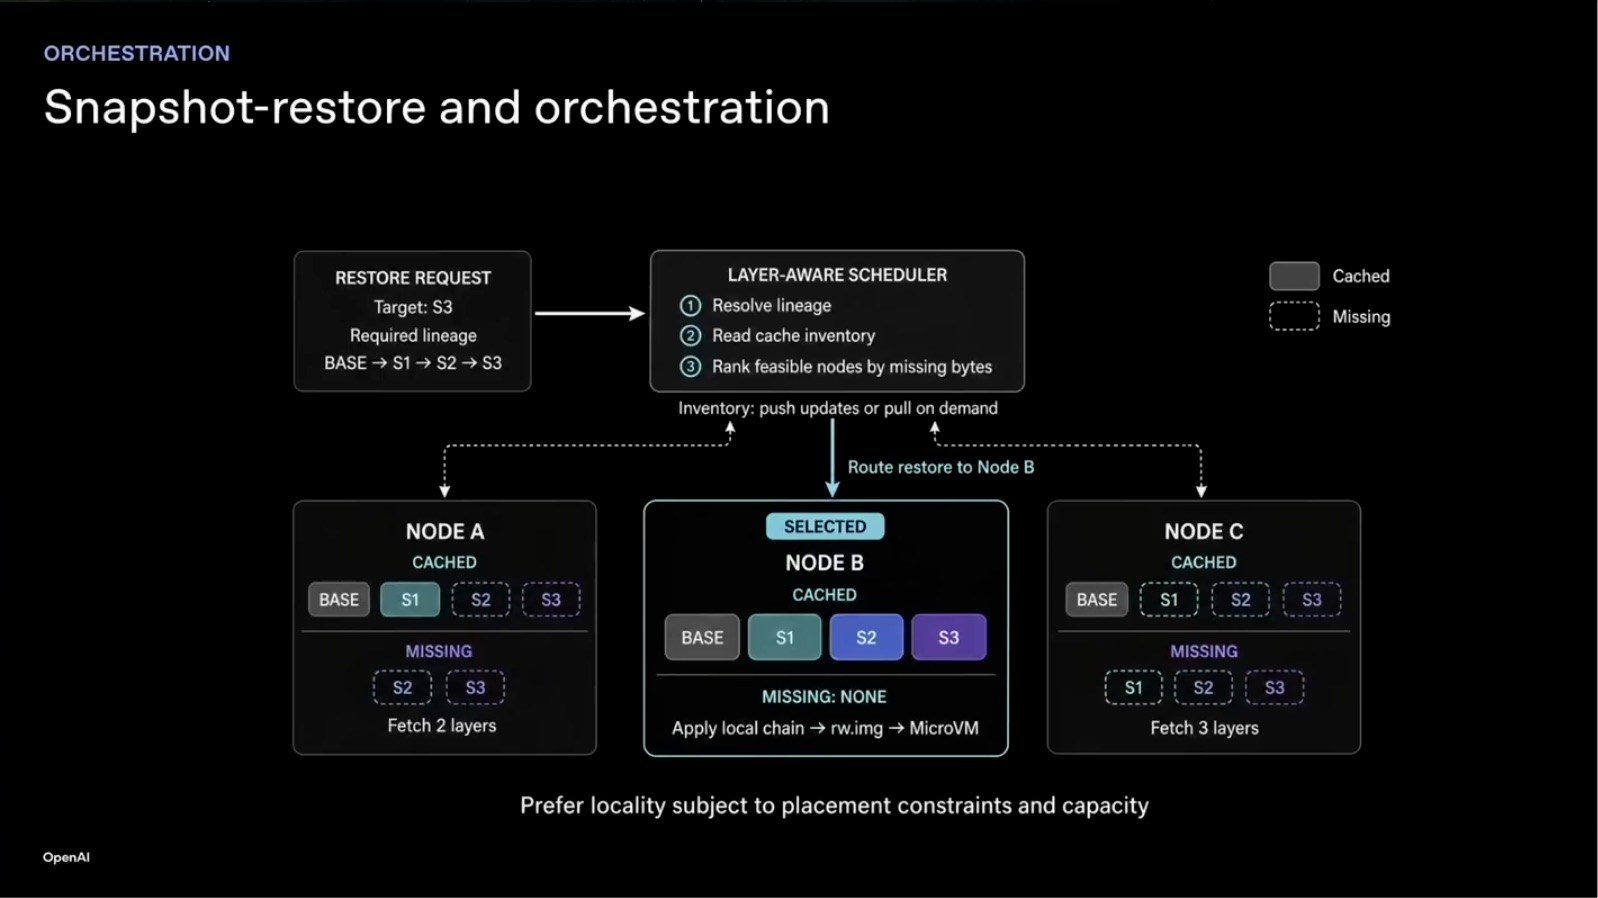
而磁盘 snapshot 不只帮助恢复,它的数据位置还可以直接参与下一次节点选择。
第 46 页|调度器为什么要懂 snapshot
沿图的请求路径看:上方的恢复请求先到 scheduler。它解析 base、S1、S2、S3 这条 snapshot lineage,再比较下方三个节点已有的缓存,按缺失字节数排序。
Node B 已经拥有全部层,因此被选中,不需要重新下载。
数据本地性只是评分条件之一,最终仍要服从节点容量和其他 placement constraints。
到这里三部分连了起来。Runtime 决定怎样运行,Persistence 把状态变成可恢复的层,Orchestration 再利用这些层的位置完成更快的调度。
这也解释了为什么整场分享必须从 fork() 一直讲到 Fleet:任何一层单独成立,都还不是完整的 Agent Sandbox Cloud。
收尾|第 47 页|怎样判断 Agent Sandbox
工具调用只表达模型想做什么。Harness 还要决定在哪里执行、给多少资源、怎样隔离、何时保存,以及故障后在哪里恢复。
从 fork 到 microVM,解决的是执行边界。从 disk snapshot 到 lineage,解决的是工作不会随节点消失。从 cluster scheduler 到 snapshot-aware routing,解决的是怎样服务大量用户。
Abhishek 最后留下的不是一套唯一架构,而是两条明确取向。安全边界应该优先做强,再想办法追回性能。可快速保存和恢复的 storage,会打开长期任务、故障恢复和多路径探索。
我把整场分享整理成四个检查问题:代码最终能碰到哪个内核;资源能不能封顶;状态能不能保存和恢复;系统能不能在大量节点之间快速调度。
下半期,我们再回到本地,具体看 Codex sandbox 怎样限制 Agent 在你的电脑上能做什么。