PPT 第 1 页|A Field Guide to Fable|严谨开场
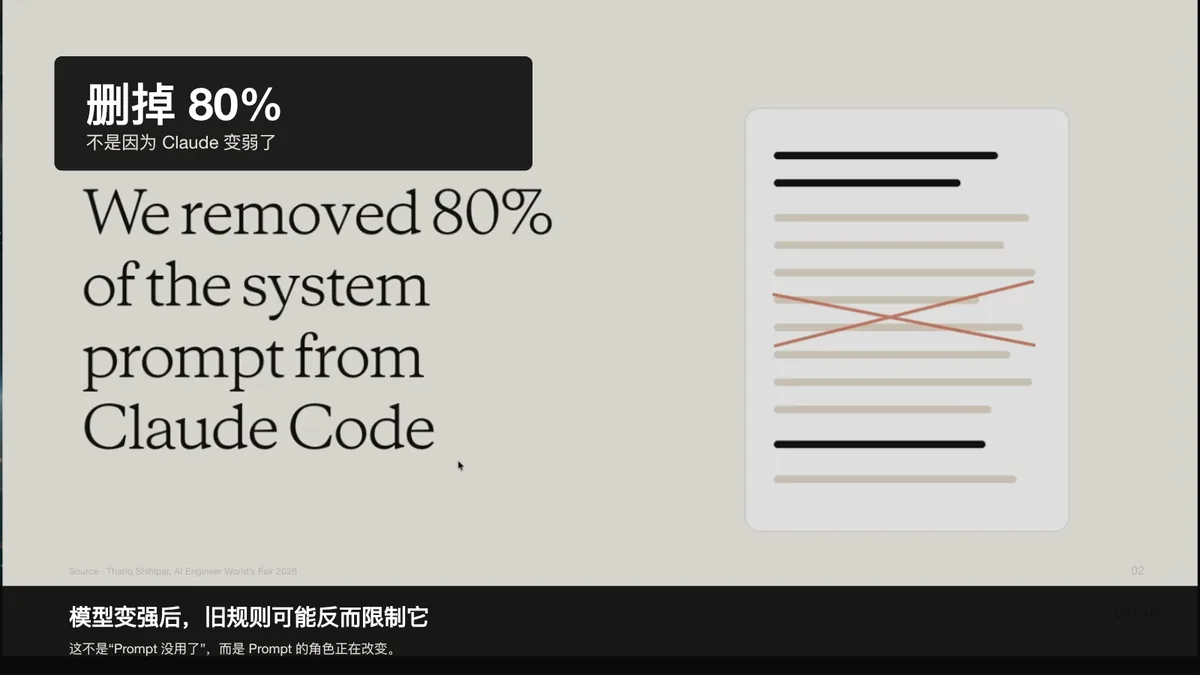
Anthropic 最近删掉了 Claude Code 80% 的系统提示词。
不是因为 Claude 变弱了。恰恰相反,是因为 Fable 5 这样的新一代模型变强之后,过去那些详细的规则和示例,反而开始限制它。
PPT 第 2 页|删除 80% 系统提示词|原始证据
这个判断不是来自二手测评,而是来自 Claude Code 开发者 Thariq Shihipar。他在 AI Engineer World’s Fair 上,分享了一份 Fable 5 实战指南。
我是 Elise,一名做 Agent 产品的 00 后 AI 产品经理。
这期我们跳过“模型又强了多少”的讨论,直接看一线 builder 为什么开始重做 Prompt、工具和工作流。
PPT 第 3 页|地图正在展开
Thariq 对 Fable 5 的形容是:The map is opening up,地图正在展开。
就像玩 RPG 游戏时,过去一直处于新手教程,而现在终于进入了开放世界。问题是,开放世界带来的不只是更多能力,也意味着我们过去积累的使用方法可能需要重做。
PPT 第 4 页|四部分内容预告
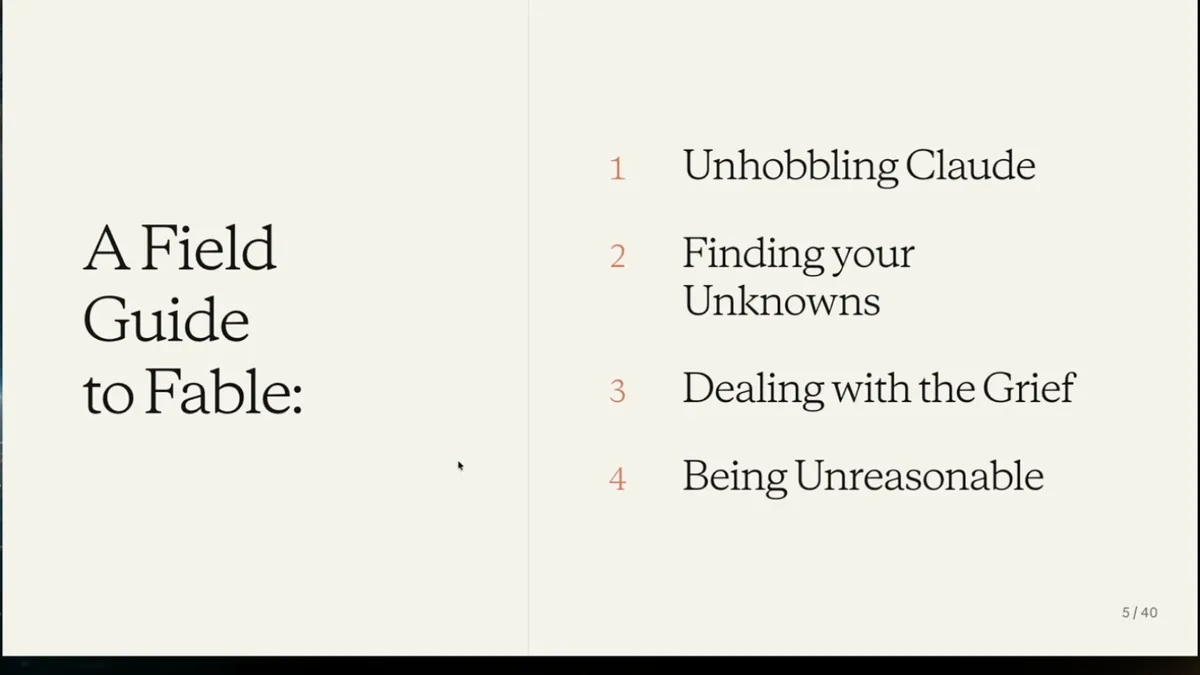
接下来只回答四个问题:怎样释放模型能力?怎样发现人的盲区?怎样面对工作方式的变化?以及,生产力提高以后,什么才真正值得做?
PPT 第 5 页|限制模型的可能是我们
Thariq 在演讲中说,限制模型的可能正是我们自己:我们为它搭建的 harness,也就是运行环境,以及我们使用 Prompt 的方式。
整场演讲最重要的判断就是:模型已经变了,但工具和工作流没变,我们使用的就仍然只是它能力的一小部分。
PPT 第 6 页|宝可梦案例
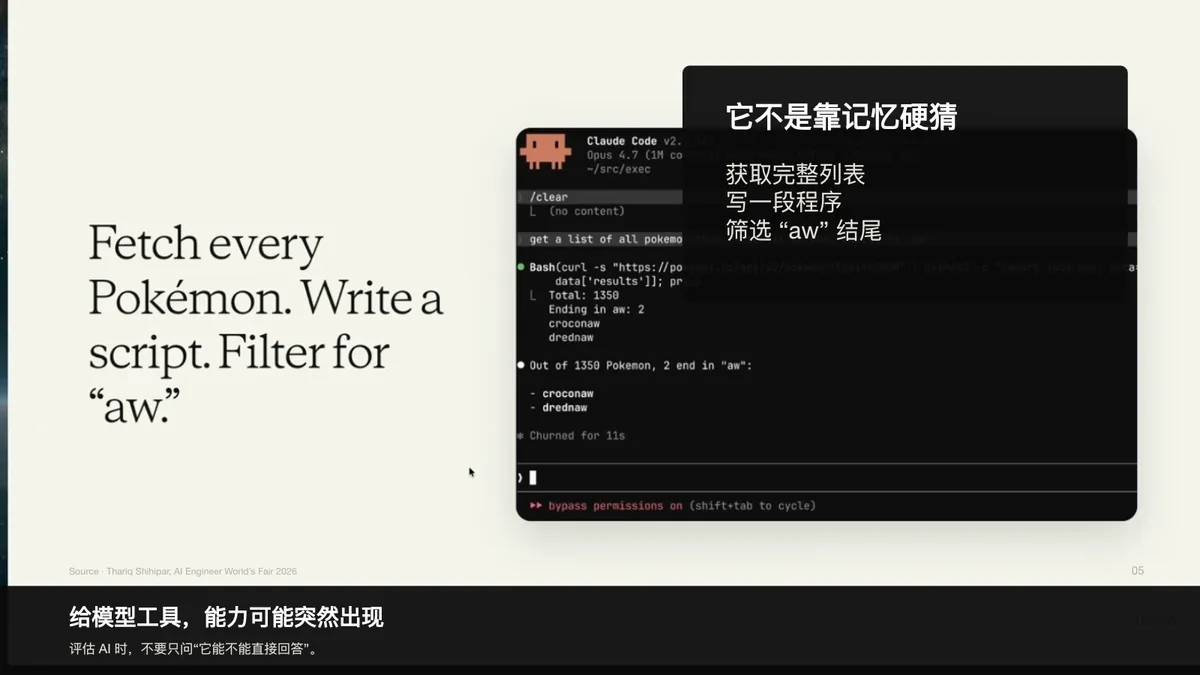
如果你问普通聊天模型:所有宝可梦里,哪些名字以 AW 结尾?它很可能回答不出来。
不是它完全不知道,而是单靠记忆在上千个名字里筛选,本来就容易出错。
但 Claude Code 可以完成这个任务。它不需要靠记忆硬猜,而是可以先获取完整的宝可梦列表,再写一段程序进行筛选,最后找到两个答案:Croconaw 和 Drednaw。
重点不是答案,而是 Claude Code 换了一种解决问题的方式:不硬猜,直接调用工具验证。
PPT 第 7 页|Capability Overhang|待释放的能力
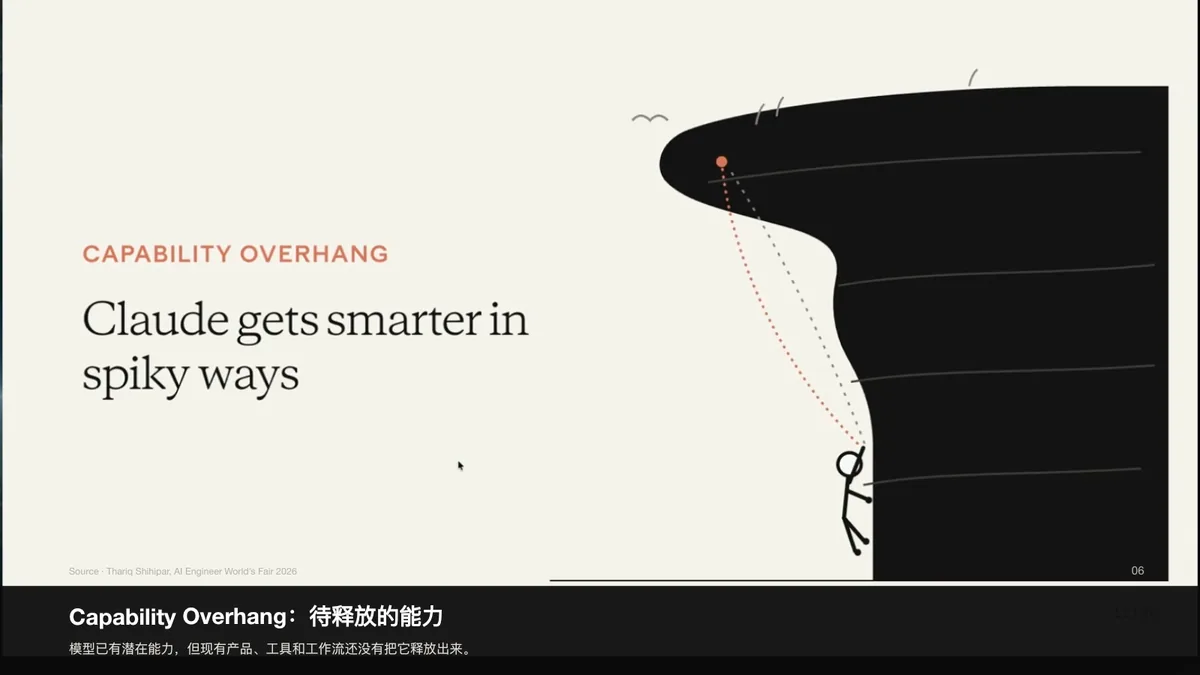
Thariq 把这种现象称为 capability overhang。
我更愿意把它叫做“待释放的能力”:能力已经在模型里,但产品形态和工具还没有把它释放出来。
AI 的能力并不是每一个维度一起、均匀地增长。它更像是以一种“尖刺式”的方式变强。
一个模型在聊天框里可能无法直接回答某个问题,但当你给它代码执行、搜索、文件系统和反馈机制之后,它可能突然就能完成一整类过去无法稳定完成的任务。
所以,不要再只用聊天框判断模型能力。真正应该问的是:给它搜索、代码执行和反馈以后,它能不能自己把答案找出来?
这也是聊天模型和 Agent 的关键区别:真正工作的不是一个模型,而是一整套“模型加工具”的系统。
PPT 第 8 页|AI 产品形态也在进化
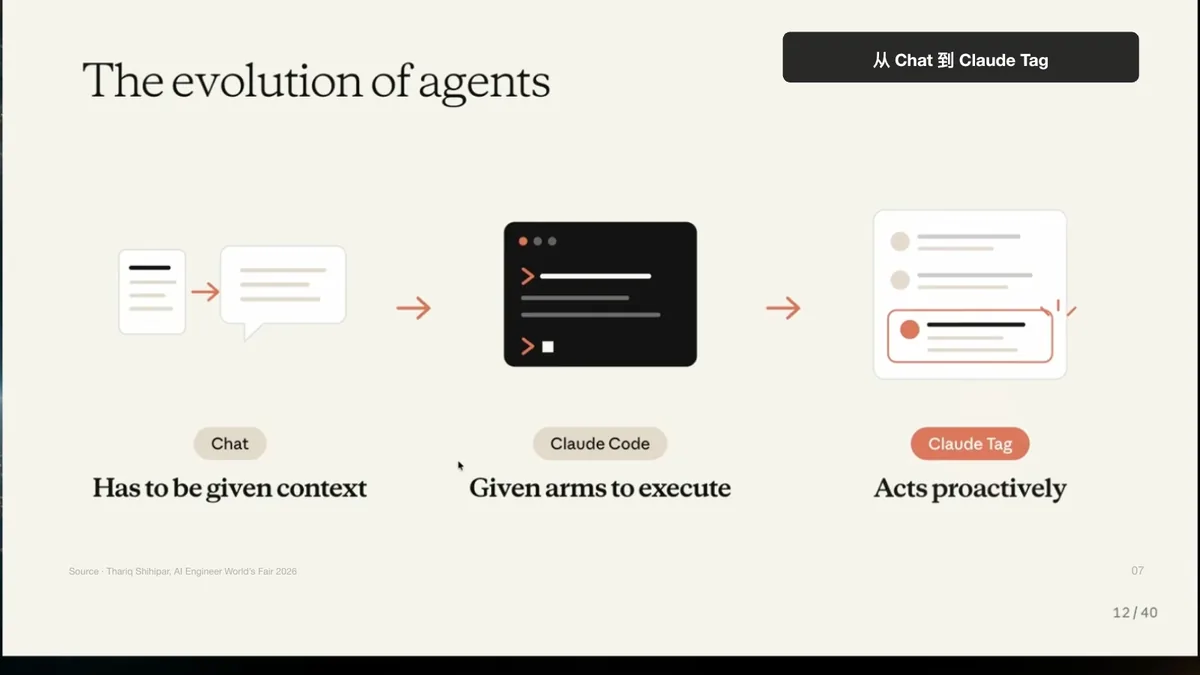
过去解决上下文问题,我们习惯把更多内容塞给模型。但 Claude Code 的核心不是更大的上下文窗口,而是给模型工具,让它自己搜索、读取和执行。
这条演进路径很清楚:Chat 等人提供上下文;Claude Code 获得执行能力;Claude Tag 则可以在多人协作中,根据事件被主动唤起并继续工作。
AI 不再只是坐在聊天框里等你提问,而是开始进入真实工作流。Claude Tag 很值得单独展开,后面我会再做一期具体讲。
PPT 第 9 页|再次回到 80% Prompt
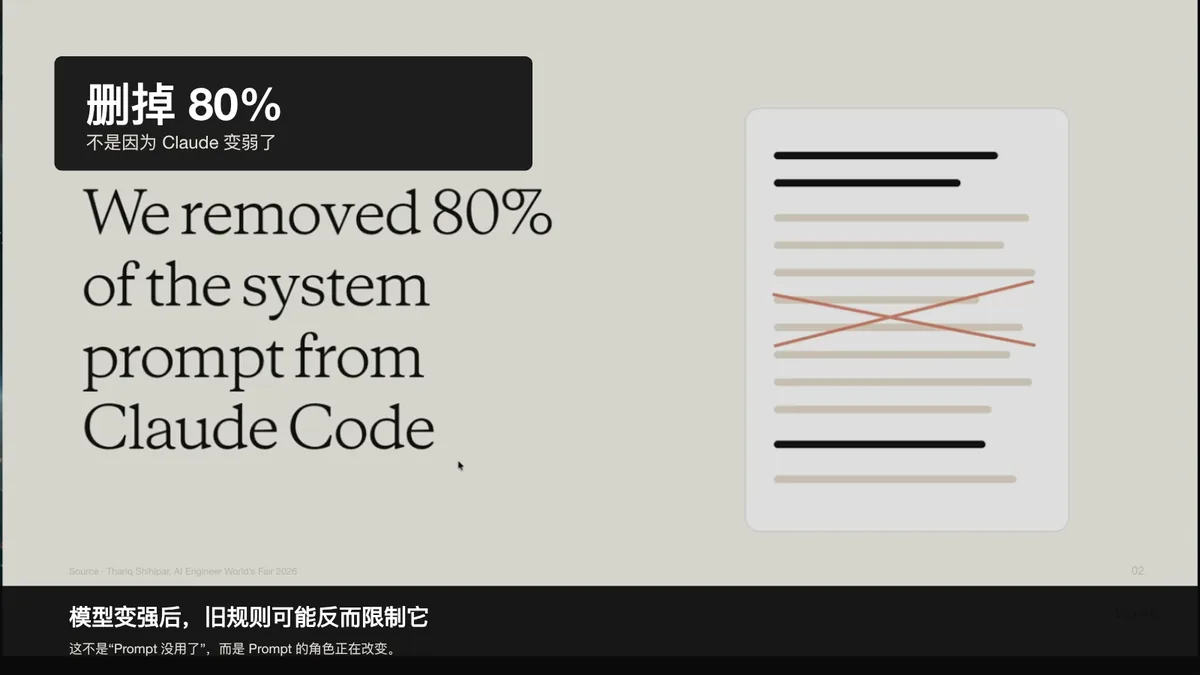
现在回到开头的 80%。模型越强,为什么系统提示词反而变短?
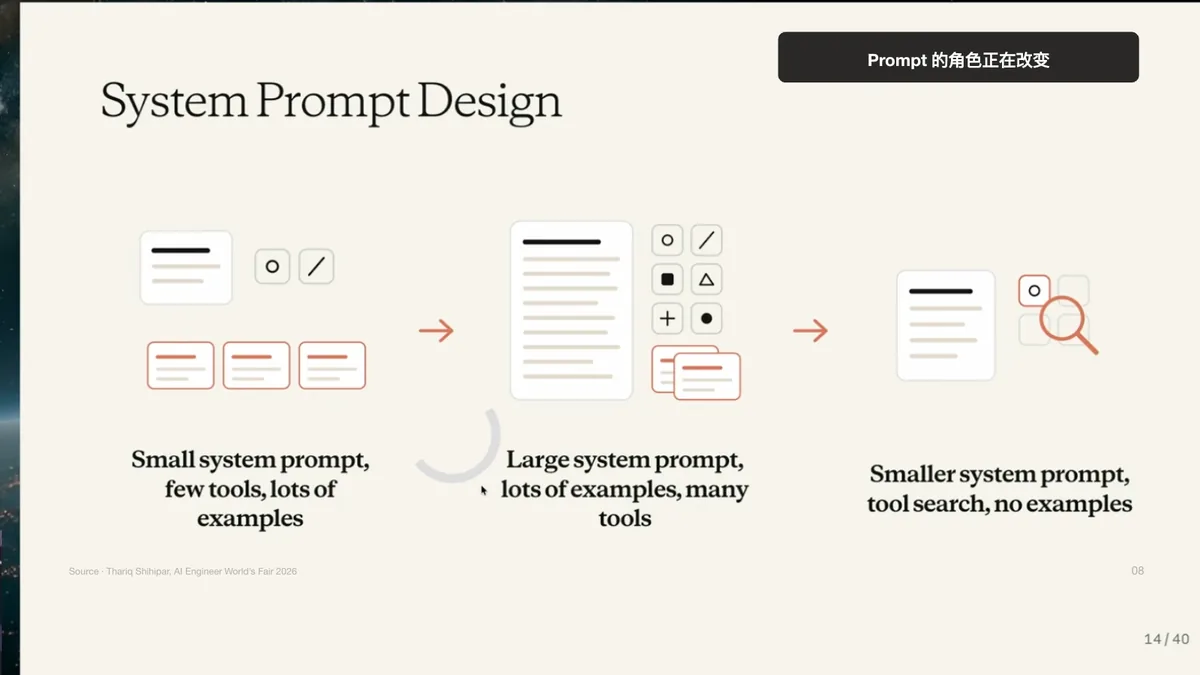
早期模型需要大量示例,后来模型更能听懂指令,系统提示词也越写越长。
PPT 第 10 页|System Prompt Design
但在 Fable 5 这一代模型上,过多示例反而可能限制它。因为模型能够想到的路径,已经超过了人类预先写进示例里的路径。
这不是 Prompt 没用了,而是 Prompt 的工作变了:少规定步骤,多说清目标、背景、边界和完成标准。
PPT 第 11 页|更像生物学,而不是物理学
Thariq 说,理解模型更像研究生物,而不是套用一条固定公式。模型长出新能力以后,最佳用法也要靠真实使用重新发现。
但模型松绑以后,下一个瓶颈可能变成了人。
PPT 第 12 页|地图不等于疆域
讲完怎么给 Claude 松绑之后,Thariq 说了一句我很喜欢的话:需要被松绑的,不只是 Claude,还有我们自己。
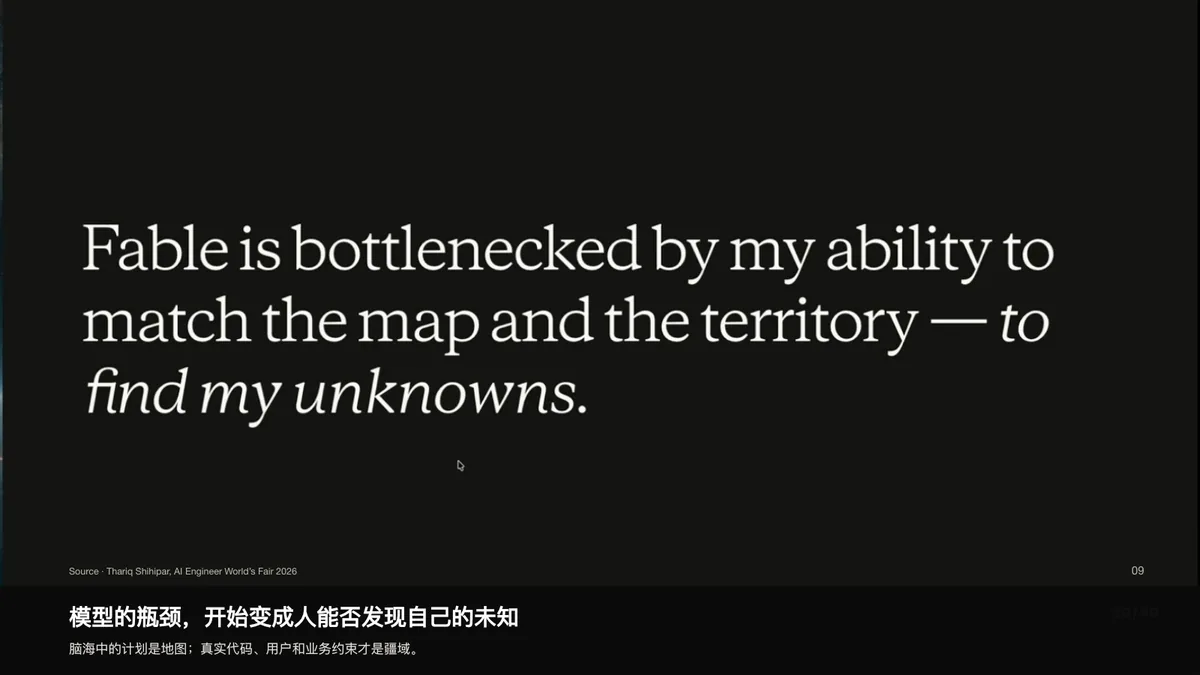
当我们给 AI 一个任务时,脑海里的计划、Prompt 和需求文档,只是一张地图。
真实的代码库、用户需求、业务规则和现实限制,才是它真正需要穿越的疆域。
而地图上没有标出来、但执行过程中一定会遇到的东西,就是未知点。
PPT 第 13 页|四种未知
真正危险的,不是需求写得不够长,而是有些问题你根本不知道自己漏掉了。
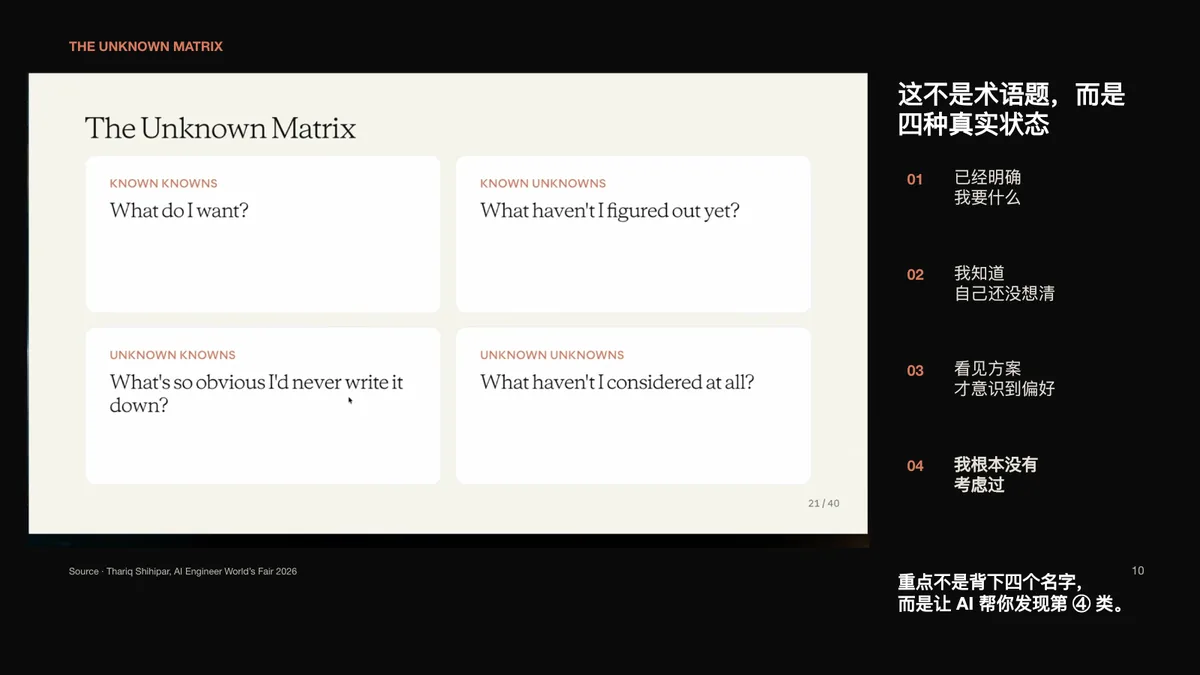
Thariq 用一个矩阵,把未知分成四种状态。
第一种,是你已经明确知道自己想要什么。这些内容可以直接写进任务。
第二种,是你知道自己还有事情没想清楚。比如应该选什么技术方案,或者产品到底服务哪一类用户。
第三种,是那些你很难提前说出来,但看见方案以后,就能立刻判断的东西。设计风格和交互体验,经常属于这一类。
最后一种,也是最危险的一种,是你根本没有意识到这个问题存在。
例如你以为自己只是在增加一个新的登录方式,但真正开始执行之后,才发现它还涉及旧账号迁移、权限继承、数据合规,以及异常情况下的回滚。
Agent 走得越远,撞上未知的概率就越高。所以,与其继续加长需求,不如先让 AI 帮你找出需求里根本没有出现的问题。
PPT 第 14 页|实践一|盲点扫描
接下来是这期最值得收藏的部分:四种今天就能用的方法。
完整中文版 Prompt 已经放在屏幕上,可以暂停或直接复制。
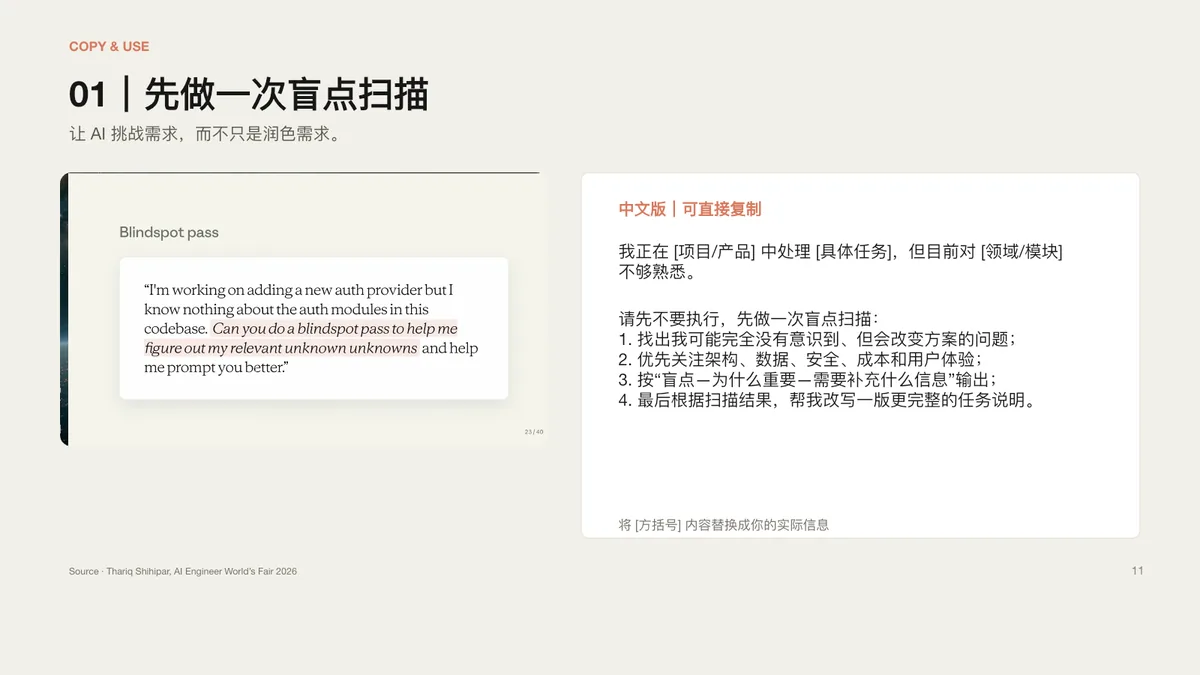
第一个方法,叫做盲点扫描。
开始执行前,先让 AI 寻找那些你没有考虑到、但会改变方案的问题。
重点关注架构、数据、安全、成本和用户体验。这不是让 AI 润色需求,而是让它挑战需求。
PPT 第 15 页|实践二|差异化原型
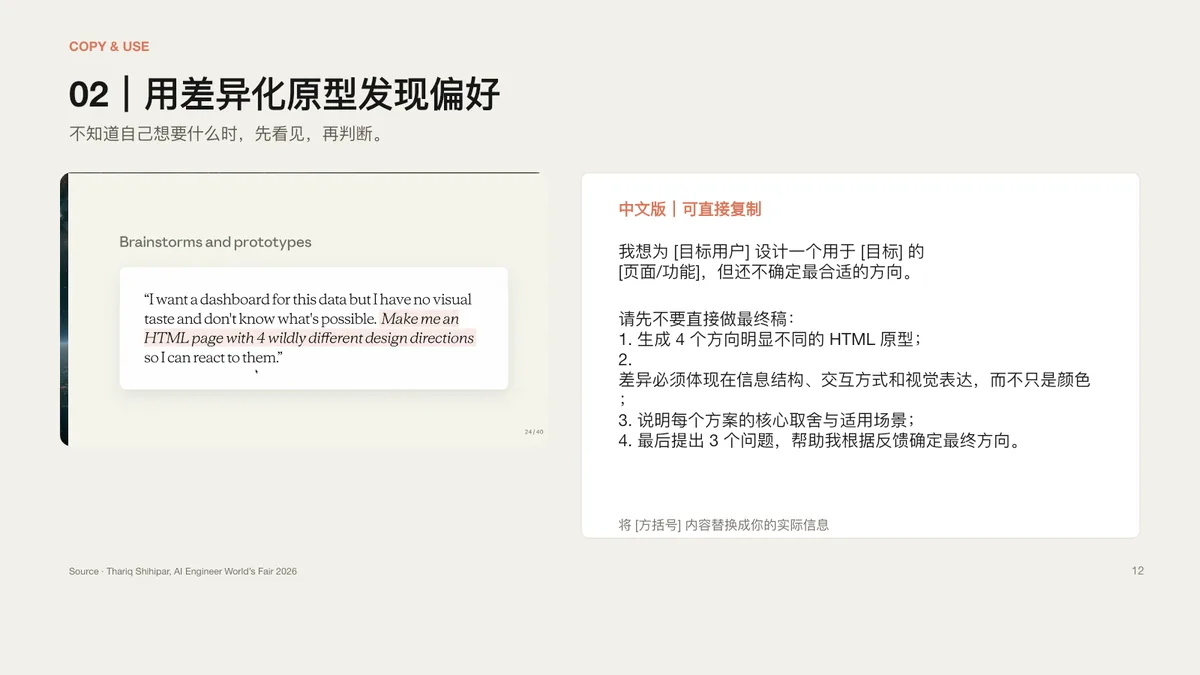
第二个方法,是用差异化原型发现偏好。
如果你说不清自己想要什么,不要硬写完美需求。先让 AI 做四个真正不同的原型。
不是换四种颜色,而是在结构、交互和视觉上真正拉开差异。
你通过比较和反馈,逐渐发现那些原本无法用语言准确描述的偏好。
PPT 第 16 页|实践三|让 AI 访谈你
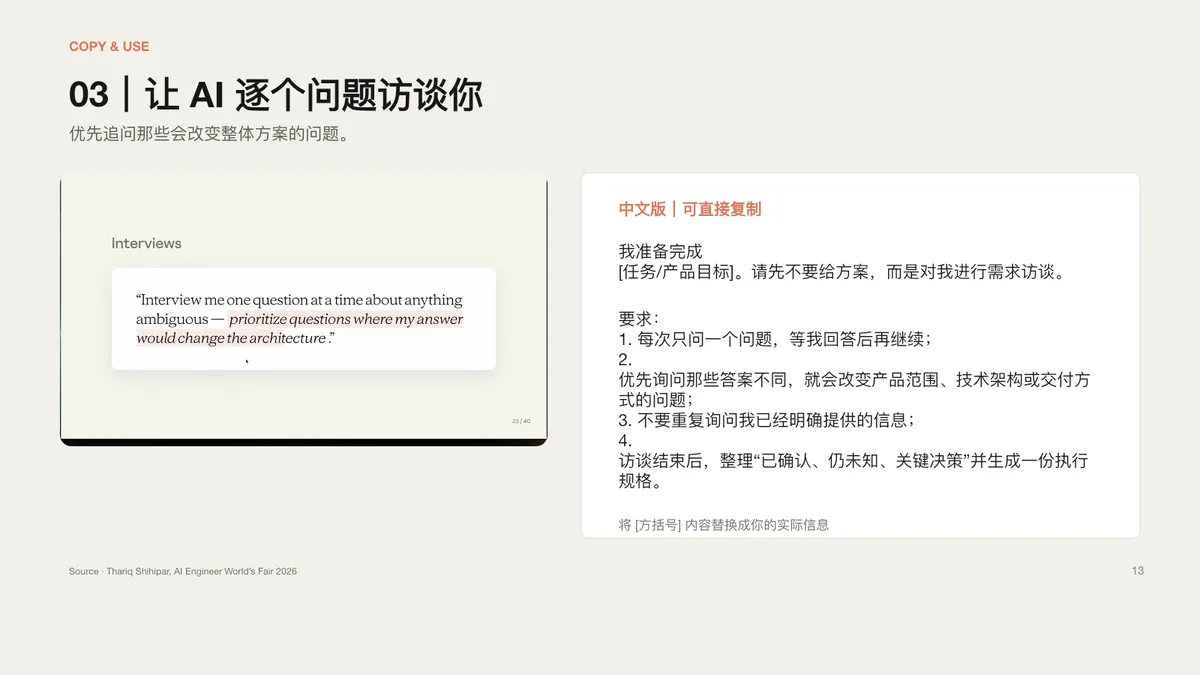
第三个方法,是让 AI 访谈你。
不要一次抛四十个问题。让它每次只问一个,并优先追问那些答案不同,就会改变产品或技术方案的问题。
问题数量不重要,能不能找到关键决策点才重要。
PPT 第 17 页|References|快速闪过
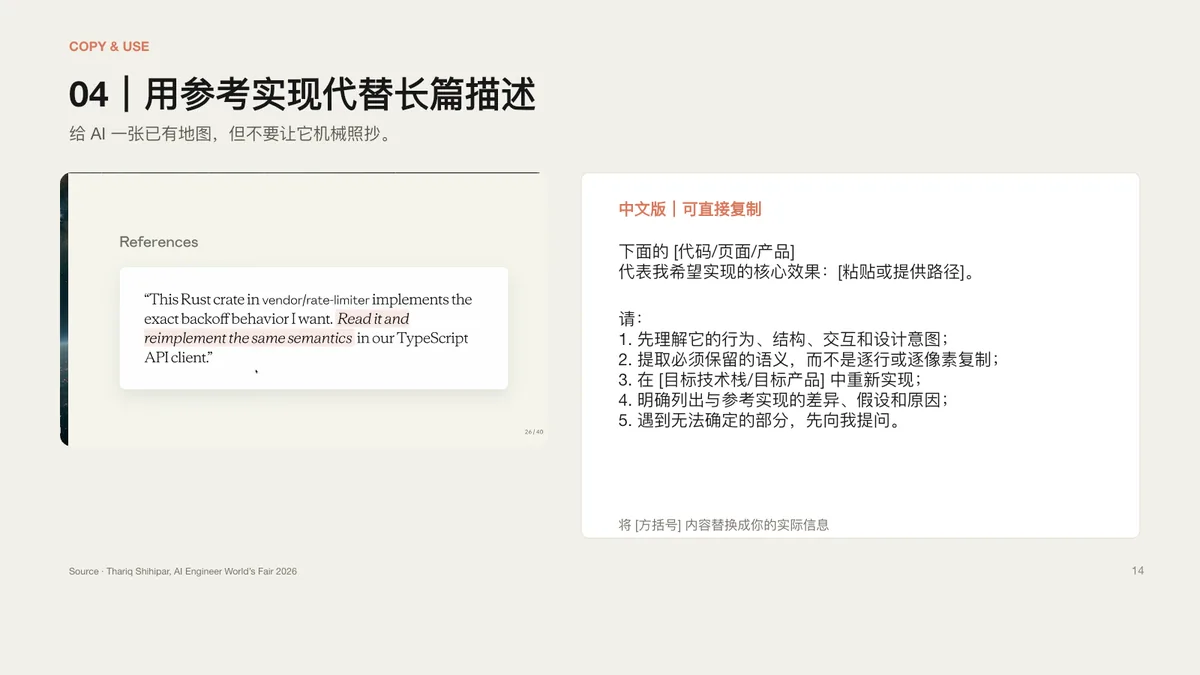
References 这一页可以快速闪过:给 AI 一个现有实现,通常比写一大段抽象描述更有效。
但要让它理解参考里的行为和设计意图,而不是机械复制。
PPT 第 18 页|实践四|记录执行偏差
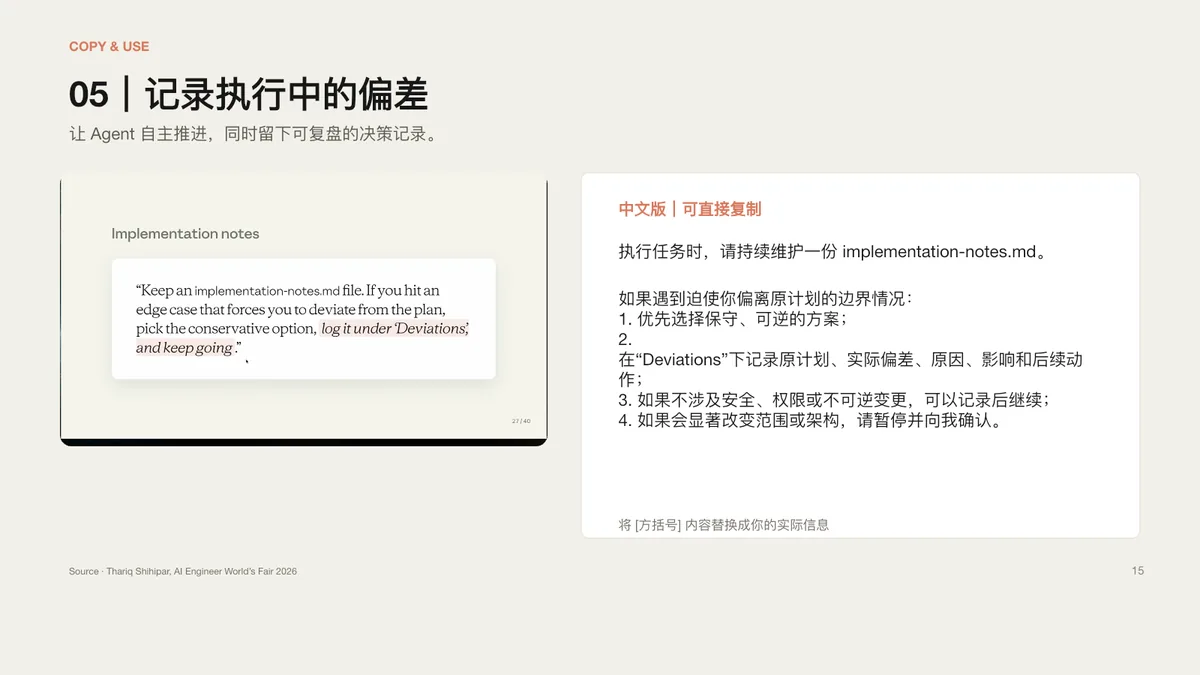
第五个方法,是让 Agent 记录执行偏差。
当 Agent 偏离计划时,让它记录原计划、偏差原因、实际选择和影响。
小问题选择保守方案继续;会改变范围、架构或产生不可逆影响的问题,必须停下来问人。
PPT 第 19 页|实践四|完成后让 AI 考你
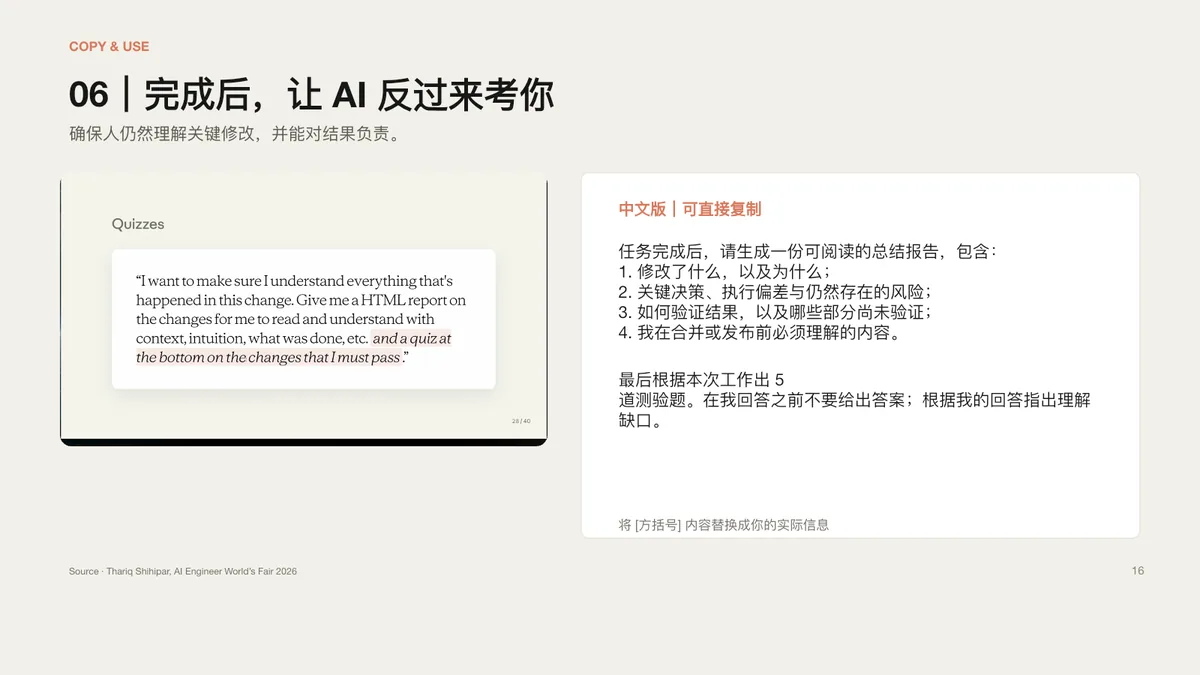
第六个方法,是完成之后,让 AI 反过来考你。
让它生成总结报告,解释改了什么、为什么改、还有什么风险。
然后让它根据这次工作反过来考你。目的不是考试,而是确认你仍然理解这份工作。
PPT 第 20 页|Staying in the loop
Agent 能自主执行,不代表人可以退出循环。
Human in the loop 不是盯着每一次点击,而是理解关键决策、发现偏差,并对结果负责。
PPT 第 21 页|效率提升也会带来失落
这场分享没有只谈兴奋,Thariq 还谈到了一种失落感。
他创业时,很多功能需要几周甚至几个月。现在回到同一个代码库,几小时就能完成。
他当然高兴,也会难过。因为他真的喜欢手写代码和掌控整个代码库的感觉。
但他也记得无数没有结果的深夜 Debug 和失败项目。
当 AI 接手我们曾经引以为豪的能力,很多人都会问:如果工作不再那么难,我的专业价值还在哪里?
Thariq 的答案是:The only way out is through。唯一的出路,就是穿过去。
PPT 第 22 页|少一点“理智”
Thariq 把最后一个建议称为 Being unreasonable,也就是少一点“理智”。
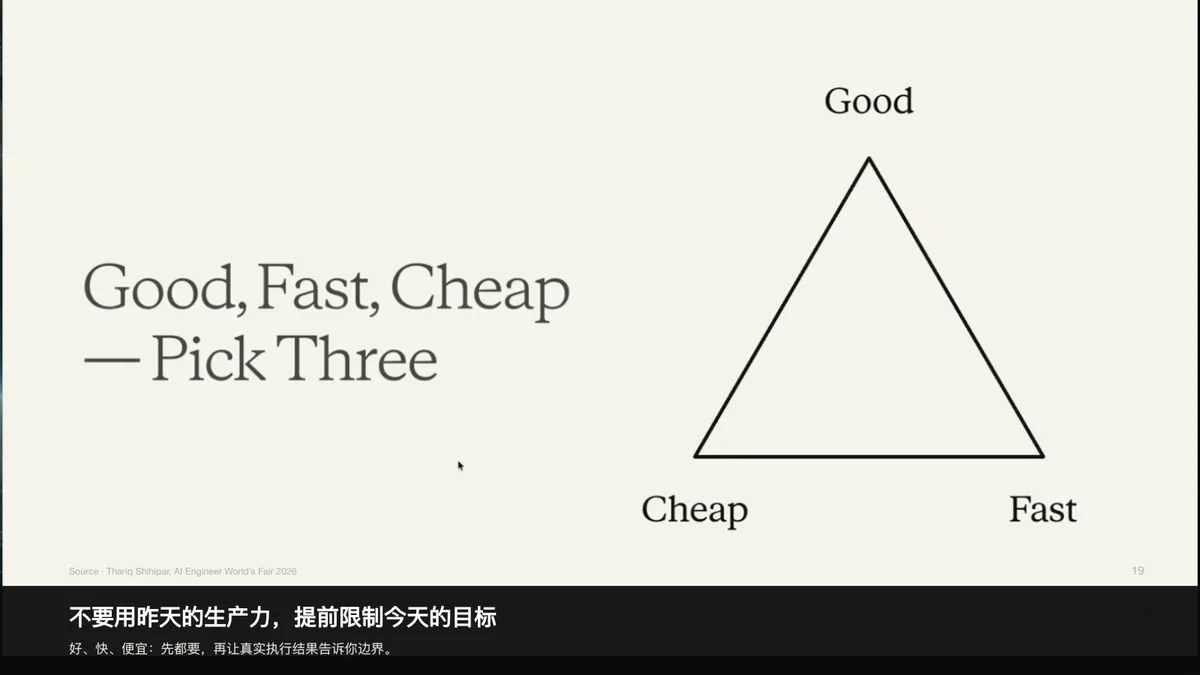
过去做产品,我们习惯在好、快、便宜之间三选二。
但 Agent 能力提高后,不要继续用昨天的生产力,替今天的目标提前设限。
这不是说取舍消失了,而是先让真实执行结果告诉你边界在哪里。
PPT 第 23 页|构建更容易,创造价值仍然很难
Thariq 最后强调了一句话:Building is easier, but generating value is still hard。
构建正在变得容易,但创造价值依然困难。
当所有人都能更快做出产品,“能不能做出来”会越来越不稀缺。
真正稀缺的是:解决什么问题、为谁解决,以及为什么有人愿意使用。AI 降低了构建成本,但没有替我们决定什么值得构建。
PPT 第 24 页|三个更底层的变化
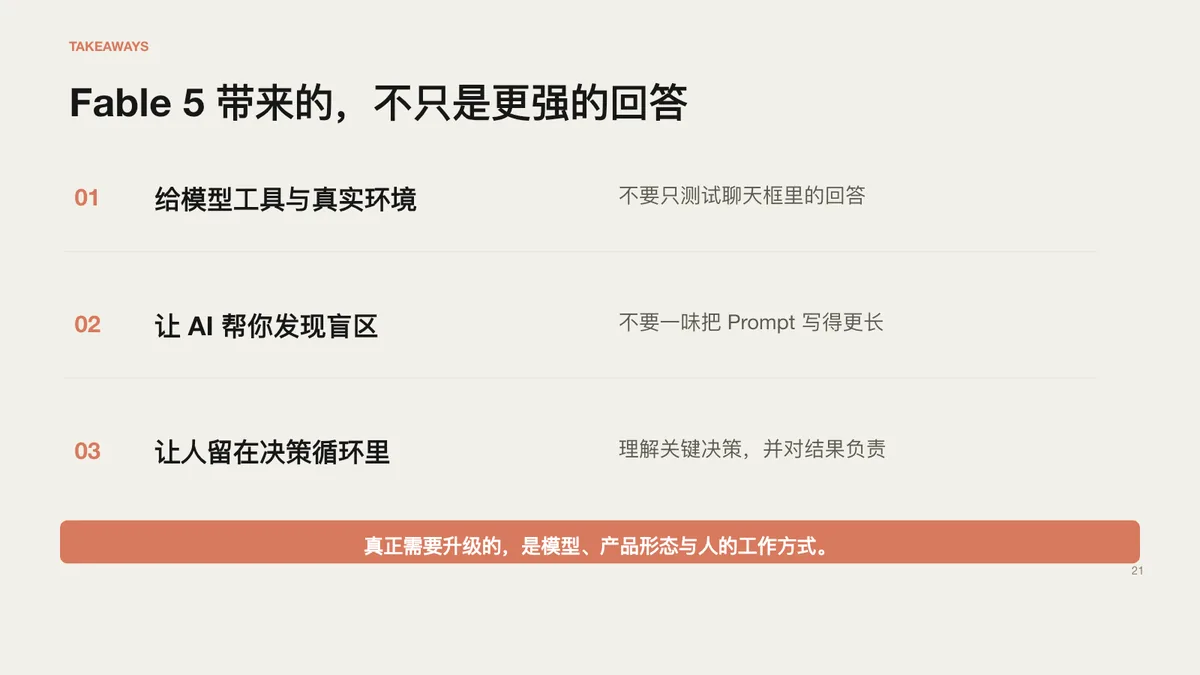
所以,这场分享真正值得带走的,不是几个 Prompt 技巧,而是三个更底层的变化。
第一,别只测试模型会不会回答,要给它工具和真实环境。第二,别一味把 Prompt 写长,要让 AI 帮你发现盲区。第三,Agent 可以更自主,但人必须理解关键决策并对结果负责。
PPT 第 25 页|结尾
下一次使用 AI,先别急着继续优化 Prompt。
先让它做盲点扫描,再生成几个差异足够大的原型;完成后记录偏差,并反过来考你。
然后看看:改变工作方式以后,你使用的还是不是“同一个模型”。
我是 Elise。这个系列,我们会少听一点二手观点,直接拆解全球一线 AI builders 正在怎么做。
就像 Thariq 在演讲最后说的:Go explore, make it real, and be less reasonable。
去探索,把它做成真的,然后少一点“理智”。